En este artículo
NEBULA es una plataforma de aprendizaje federado para diseñar, ejecutar y observar experimentos con coordinación centralizada o entre pares. Su utilidad para investigación está en conectar el entrenamiento con las condiciones de la red: topología, participación, recursos y comportamiento de los participantes.
Esta guía explica cómo plantear un experimento reproducible, qué información conservar y cómo interpretar sus resultados. Las capacidades de una versión concreta deben comprobarse en la documentación y el código utilizados.
Recursos oficiales y relación con Fedstellar
El repositorio de CyberDataLab identifica NEBULA como evolución de Fedstellar y documenta tres componentes principales: frontend, controller y core. También enlaza la guía de instalación vigente. Usa esas instrucciones para los requisitos y comandos de la versión elegida.
La plataforma cuenta con una publicación de Fedstellar en Expert Systems with Applications y una demostración de NEBULA en ACM SIGCOMM 2025. Para acceso y novedades, el repositorio enlaza nebula-dfl.com y nebula-dfl.eu.
Arquitectura: separar experimento y aprendizaje
El frontend permite configurar y observar escenarios. El controller orquesta su ejecución. El core opera en cada participante y realiza el proceso federado. Esta separación es relevante: un entrenamiento entre pares puede coexistir con un servicio central para lanzar experimentos o visualizar resultados.
En una evaluación de disponibilidad, distingue el fallo del dashboard, el de la orquestación y el de un participante. No implican necesariamente la misma interrupción. Define qué proceso debe continuar y compruébalo mediante una prueba controlada.
La guía de fundamentos de DFL explica por qué descentralizar la agregación no elimina todas las dependencias del sistema.
Antes de instalar: definir una pregunta comprobable
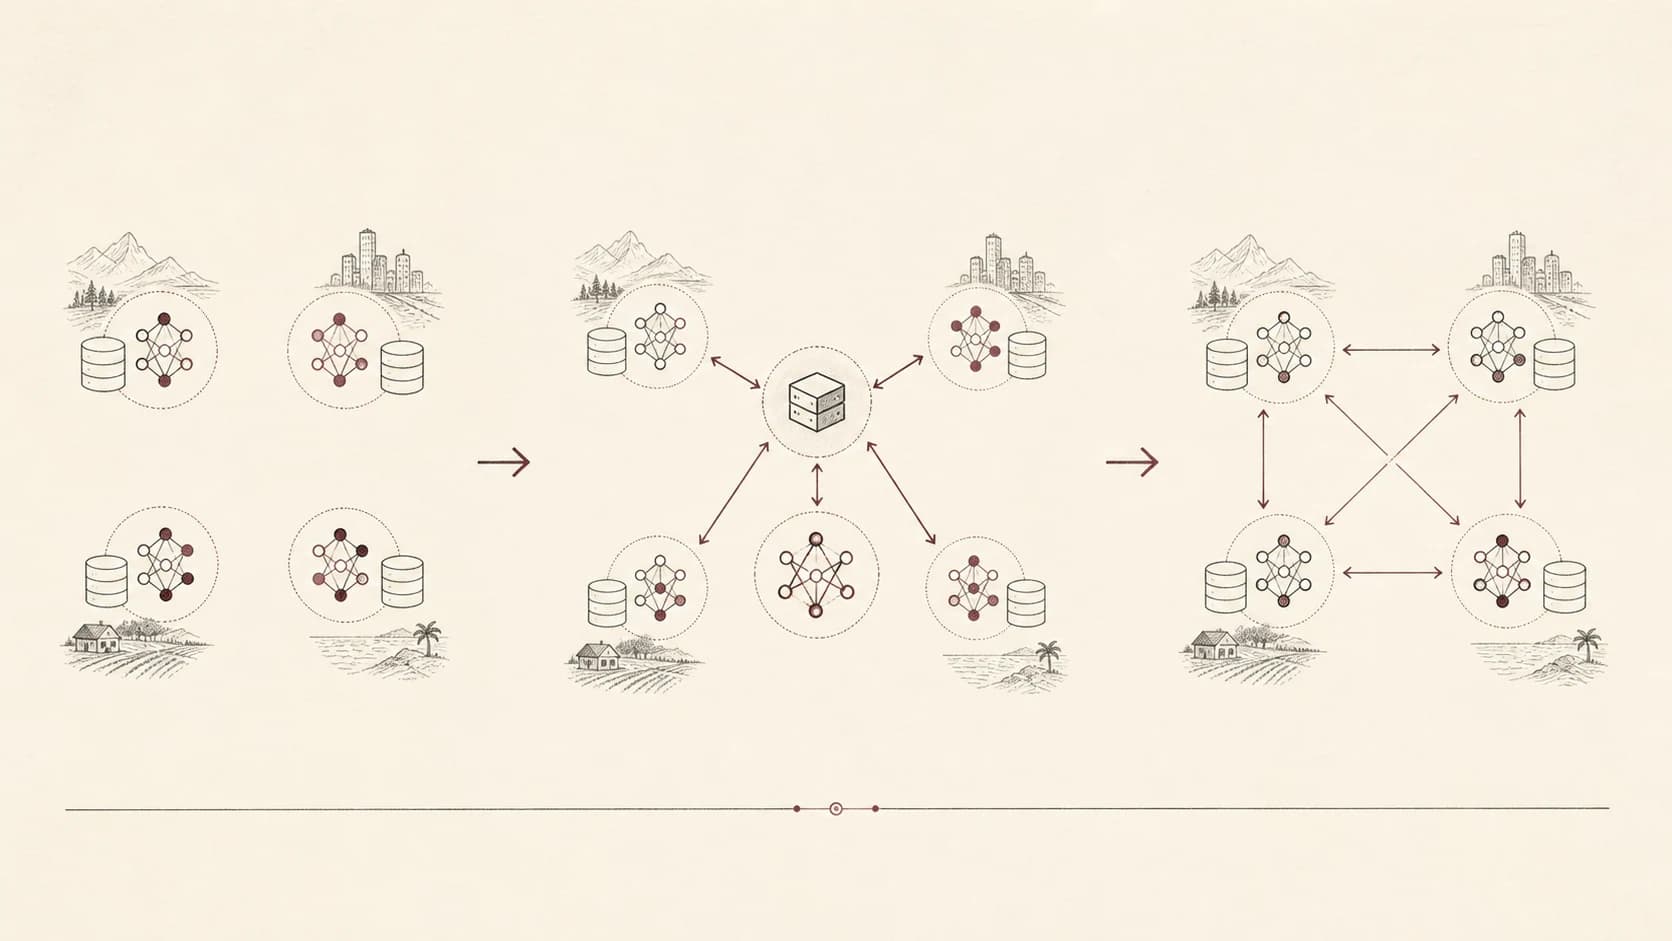
Un primer experimento debería responder a una pregunta pequeña: ¿cómo cambia el coste hasta alcanzar una calidad objetivo cuando sustituimos una estrella por un anillo? Evita cambiar al mismo tiempo dataset, modelo, topología y defensa, porque después no podrás atribuir el resultado.
Documenta el conjunto de datos, licencia, preparación, partición por cliente, semillas y política de validación. Si hay series temporales, realiza la partición antes de crear ventanas. Si hay dispositivos o sujetos repetidos, comprueba que no aparecen en entrenamiento y test cuando el objetivo es medir generalización.
Protocolo de experimento propuesto
- Fija la versión. Conserva commit o release, entorno de ejecución y versiones de dependencias relevantes.
- Comprueba un cliente. Verifica que el modelo aprende localmente y que las etiquetas y métricas son correctas.
- Establece una referencia. Ejecuta aprendizaje local y una federación sin ataques bajo el mismo presupuesto.
- Cambia una condición. Modifica topología, heterogeneidad o fallo manteniendo el resto del protocolo.
- Repite ejecuciones. Conserva todas las semillas y también las ejecuciones fallidas.
- Exporta evidencia. Guarda configuración, registros, curvas por cliente y métricas de recursos con el mismo identificador de ejecución.
Esta secuencia es una propuesta metodológica, no una API ni una configuración lista para importar. La instalación exacta corresponde a la documentación oficial.
Qué medir además de la precisión
| Dimensión | Registro recomendado | Error que ayuda a detectar |
|---|---|---|
| Calidad local | F1 y recall por cliente y clase | Una media alta oculta un cliente perjudicado |
| Tiempo | Duración de ronda y tiempo a calidad objetivo | Una mejora necesita muchas más rondas |
| Red | Bytes enviados, recibidos y retransmitidos | Confundir payload con coste total |
| Recursos | Memoria máxima y uso de CPU/GPU | Una media oculta picos inviables |
| Disponibilidad | Participantes activos y actualizaciones obsoletas | Evaluar únicamente los nodos rápidos |
| Defensa | Rechazos correctos y falsos rechazos | Penalizar heterogeneidad legítima |
No compares directamente porcentajes de CPU de máquinas distintas sin describir hardware y método de medición. Para energía, una aproximación basada en utilización debe etiquetarse como estimación; no equivale a una medida eléctrica.
Seguridad y privacidad: propiedades que deben comprobarse
La disponibilidad de módulos de seguridad no significa que una ejecución concreta active todos los controles. Registra qué mecanismos están habilitados, qué parámetros utilizan y qué observa cada participante. Mantener los datos locales no garantiza que las actualizaciones sean privadas.
El repositorio documenta uso de Opacus para entrenamiento con privacidad diferencial. Para evaluar una configuración, exige unidad protegida, recorte, ruido, muestreo y contabilidad del presupuesto. Añadir ruido a un tensor sin describir estos elementos no demuestra una garantía. Tampoco un método vacío llamado secure_aggregation implementaría un protocolo criptográfico.
Para estudiar defensa, empieza con escenarios de laboratorio y límites claros. Compara datos limpios y perturbados, mide el coste del mecanismo y registra qué clientes legítimos pierden influencia. La guía de agregación bizantina detalla esos compromisos.
Diagnóstico cuando la federación no mejora
Si todos los clientes aprenden localmente pero la federación empeora, revisa compatibilidad de parámetros, significado de las etiquetas, normalización y ponderación. Si algunos no avanzan, distingue fallo de entrenamiento, retraso de red y ausencia de participación. Si una defensa rechaza casi todo, evalúa el umbral con datos limpios antes de atribuirlo a ataques.
Conserva la secuencia temporal de eventos. Una caída de calidad posterior a un timeout puede deberse a una actualización desactualizada, pero la correlación temporal no basta: repite el caso cambiando solo esa condición.
Un siguiente experimento con valor de investigación
Tras reproducir la referencia, prueba desconexión y reincorporación de un nodo con datos diferentes. Mide recuperación local, cambios en los vecinos y bytes adicionales, además del resultado final. Este diseño conecta redes dinámicas con calidad del aprendizaje sin prometer mejoras universales.
La guía de diseño DFL ayuda a definir el protocolo; el análisis de comunicación con prototipos permite estudiar si conviene cambiar el objeto intercambiado. NEBULA aporta el entorno de experimentación, mientras la validez del resultado depende de la pregunta, los controles y la evidencia conservada.