En este artículo
Muchos modelos de aprendizaje automático útiles requieren datos de más de una organización o dispositivo. Eso plantea una pregunta práctica: ¿cómo entrenar modelos respetando privacidad, confidencialidad y soberanía del dato? El Aprendizaje Federado (FL) es una respuesta a ese problema.
¿Qué es el Aprendizaje Federado?
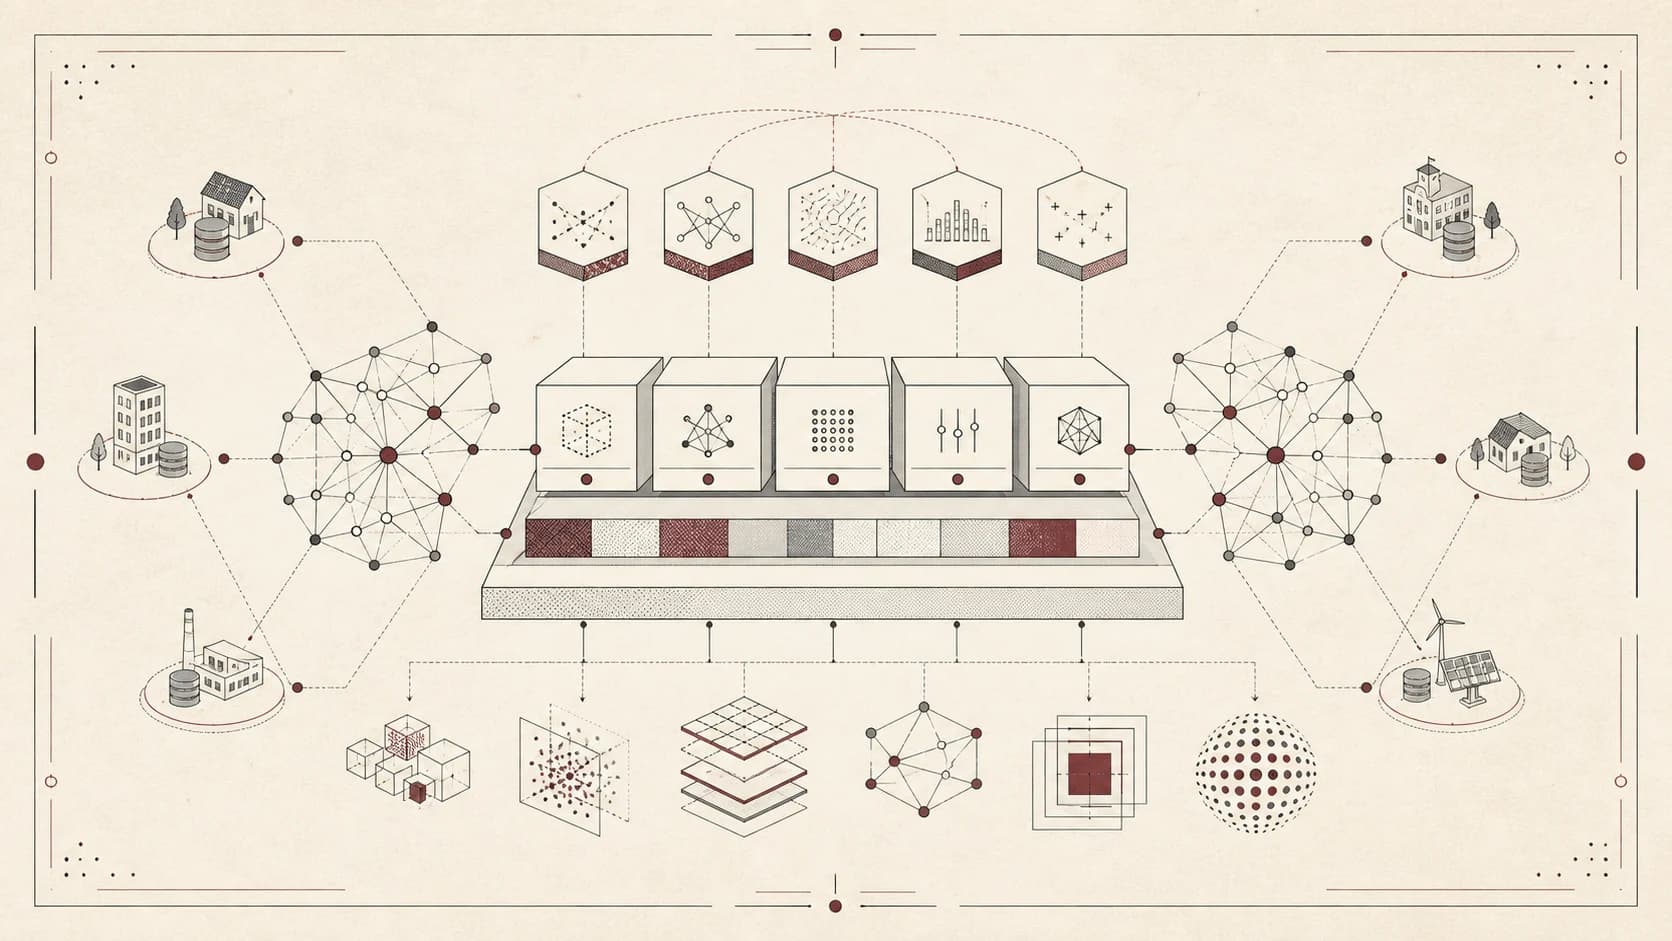
El Aprendizaje Federado es un paradigma de aprendizaje automático que permite entrenar un modelo a través de múltiples dispositivos descentralizados o servidores que guardan muestras de datos locales, sin intercambiar dichas muestras. En lugar de centralizar los datos en una única ubicación, el FL permite que los modelos se entrenen de manera colaborativa manteniendo los datos crudos distribuidos localmente.
El Principio Central
La idea fundamental detrás del aprendizaje federado es simple pero muy poderosa:
- Entrenamiento Local: Cada participante entrena un modelo con sus propios datos locales.
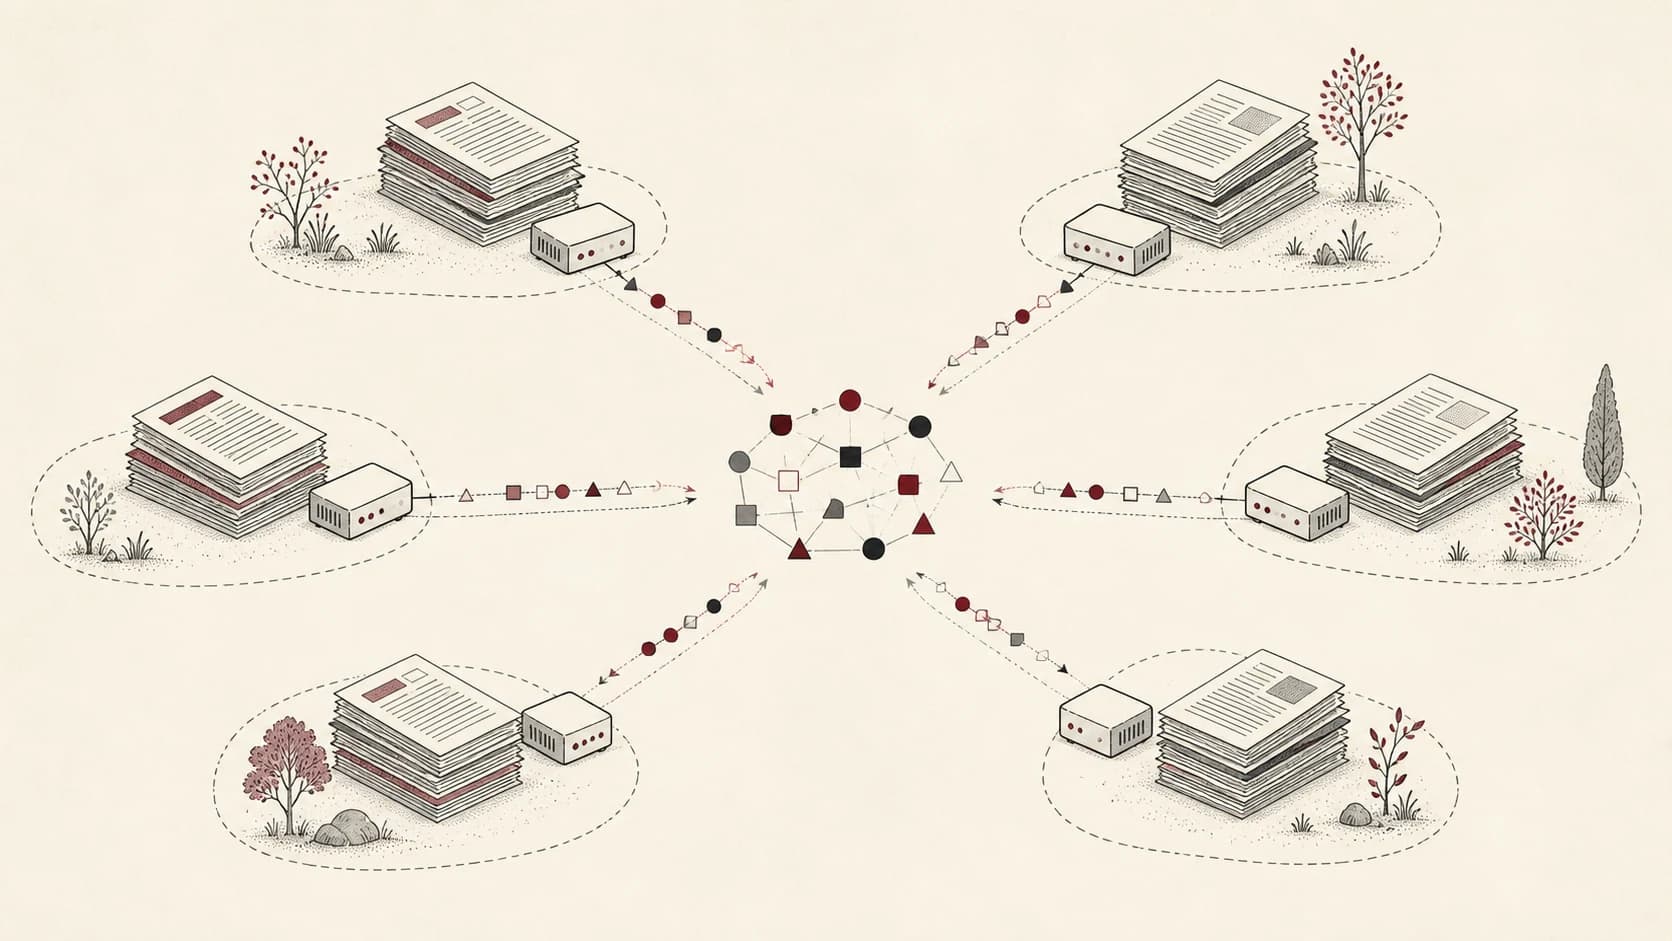
- Agregación del Modelo: Únicamente se comparten las actualizaciones del modelo (nunca los datos brutos).
- Modelo Global: Un servidor central agrega todas estas actualizaciones para crear un modelo global mejorado.
- Distribución: El modelo mejorado se envía de vuelta a todos los participantes para la siguiente ronda de entrenamiento.
Este proceso se iterará hasta que el modelo converja a un nivel de rendimiento satisfactorio.
¿Por qué es Importante el Aprendizaje Federado?
Localidad de datos y controles de privacidad
Los enfoques tradicionales de machine learning requieren que los datos estén centralizados, lo que plantea riesgos de privacidad significativos:
- Brechas de Datos: Los repositorios de datos centralizados son objetivos muy atractivos para los ciberataques.
- Cumplimiento Normativo (Compliance): El GDPR, CCPA, y otras normativas de privacidad hacen que compartir datos sea complejo y legalmente arriesgado.
- Confianza del Usuario: Los usuarios están cada vez más concienciados del uso de sus datos.
El aprendizaje federado reduce la necesidad de centralizar datos, pero requiere controles adicionales para proteger las actualizaciones y evaluar la exposición residual.
Aplicaciones del Mundo Real
El aprendizaje federado se está usando en distintos sectores donde centralizar datos no siempre es viable:
Ámbito de la Salud
- Imágenes Médicas: Diversos hospitales pueden colaborar para obtener diagnosis exactas manteniendo los historiales bajo control de cada centro, con una evaluación de privacidad específica.
- Descubrimiento de Fármacos: Ayuda a que las empresas farmacéuticas aúnen ideas preservando descubrimientos privados.
- Ensayos Clínicos: Los ensayos multi-sede pueden compartir lo aprendido pero mantener controles locales sobre los datos de cada participante.
Servicios Financieros
- Detección de Fraude: Múltiples bancos pueden mejorar sus sistemas antifraude de forma colaborativa sin compartir las transacciones de sus clientes.
- Puntuación Crediticia (Credit Scoring): Las instituciones financieras pueden crear evaluaciones de riesgo compartiendo inferencia, pero custodiando sólidamente las operaciones y métricas crudas.
Aplicaciones Móviles
- Texto Predictivo: Los teclados de un smartphone pueden aprender a sugerir frases basándose en el historial tipográfico local, sin subir los mensajes brutos en el protocolo de entrenamiento.
- Sistemas de Recomendación: Las apps pueden proporcionar sugerencias a medida y fuertemente personalizadas evitando centralizar las preferencias brutas del usuario para entrenar.
Análisis Técnico en Profundidad
Arquitecturas de Aprendizaje Federado
Existen múltiples tipos de arquitecturas en la estructura FL, cada una se amolda mejor a un escenario distinto:
1. Aprendizaje Federado Horizontal (HFL)
También conocido como aprendizaje federado basado en muestras, el HFL se emplea cuando los participantes cuentan con datos definidos bajo las mismas features (características) pero diferentes muestras.
Participante A: [datos_usuario1, datos_usuario2, datos_usuario3]
Participante B: [datos_usuario4, datos_usuario5, datos_usuario6]
Participante C: [datos_usuario7, datos_usuario8, datos_usuario9]
Caso de Uso: Múltiples hospitales con bases de datos con la misma estructura pero pacientes diferentes.
2. Aprendizaje Federado Vertical (VFL)
También conocido como aprendizaje federado basado en características (features), el VFL entra en juego cuando los participantes tienen las mismas muestras, pero diferentes features.
Participante A: [features_usuario1_A, features_usuario2_A, features_usuario3_A]
Participante B: [features_usuario1_B, features_usuario2_B, features_usuario3_B]
Caso de Uso: Un banco y una cooperativa de comercio colaborando conjuntos de datos (diferentes atributos) sobre unos mismos clientes cruzados para analizar su comportamiento.
3. Aprendizaje Federado por Transferencia (FTL)
FTL aplica aprendizaje por transferencia cuando existe poco solapamiento tanto de muestras como de características entre participantes. Se distingue de las distribuciones non-IID que también aparecen en FL horizontal; un cambio de distribución por sí solo no define FTL. Esta taxonomía sigue a Yang y colaboradores.
El Algoritmo de Federated Averaging (FedAvg)
Un algoritmo de referencia para FL es FedAvg (Federated Averaging), propuesto por Brendan McMahan et al. en 2017:
# Pseudocódigo simplificado de FedAvg
def federated_averaging(global_model, client_models, client_weights):
    """
    Agrega modelos locales usando una ponderación por promedios

    Args:
        global_model: Parámetros del modelo global maestro en esta ronda
        client_models: Lista de parámetros de lo aprendido por cada participante
        client_weights: Lista referida a los pesos que se aplican para ponderar cada participante (basado habitualmente en volumen de tuplas locales)
    """
    if not client_models or len(client_models) != len(client_weights):
        raise ValueError("Provide one weight per client model")
    if any(weight < 0 for weight in client_weights) or sum(client_weights) <= 0:
        raise ValueError("Weights must be nonnegative with a positive sum")
    aggregated_model = {}

    for param_name in global_model.keys():
        weighted_sum = 0
        total_weight = sum(client_weights)

        for i, client_model in enumerate(client_models):
            weighted_sum += client_weights[i] * client_model[param_name]

        aggregated_model[param_name] = weighted_sum / total_weight

    return aggregated_model
Retos Técnicos y Soluciones
Sobrecarga Adicional de Comunicaciones
Desafío: entrenar modelos de forma federada exige comunicación frecuente entre participantes y coordinador. Si algunos nodos tienen conectividad limitada, las actualizaciones pueden volverse lentas, costosas o inestables.
Soluciones:
- Compresión de modelo: cuantización y pruning reducen el tamaño de las actualizaciones.
- Comunicación dinámica o selectiva: compartir solo deltas o pesos relevantes evita tráfico innecesario.
- Actualizaciones asíncronas: permiten que dispositivos con ritmos distintos contribuyan sin bloquear toda la federación.
Heterogeneidad en los Sistemas (Agentes)
Desafío: un teléfono, un gateway IoT y un servidor edge tienen capacidades muy distintas de cómputo, energía y conectividad.
Soluciones:
- Agregación adaptativa: elegir pesos coherentes con el objetivo de aprendizaje; priorizar dispositivos rápidos puede sesgar la representación.
- Agregación robusta: usar mediana, trimmed mean u otras defensas para reducir el efecto de outliers o participantes maliciosos.
- FL personalizado: permitir modelos adaptados a cada contexto local cuando un único modelo global no representa bien todos los datos.
Ciberamenazas y Ataques hacia la propia Privacidad
Desafío: las actualizaciones de modelo pueden filtrar información sobre los datos locales si no se protegen adecuadamente. Ataques como model inversion o gradient leakage muestran que "no compartir datos brutos" no basta por sí solo.
Soluciones:
- Privacidad diferencial: añadir ruido controlado a gradientes o métricas para limitar filtraciones.
- Agregación segura: usar protocolos criptográficos para que el coordinador observe solo resultados agregados.
- Cifrado homomórfico: operar sobre datos cifrados en escenarios donde el coste computacional sea asumible.
Mi trabajo en aprendizaje federado
Como investigador postdoctoral en IA, ciberseguridad y aprendizaje federado, continúo trabajando en varios retos del aprendizaje descentralizado:
Aprendizaje Federado Descentralizado (DFL)
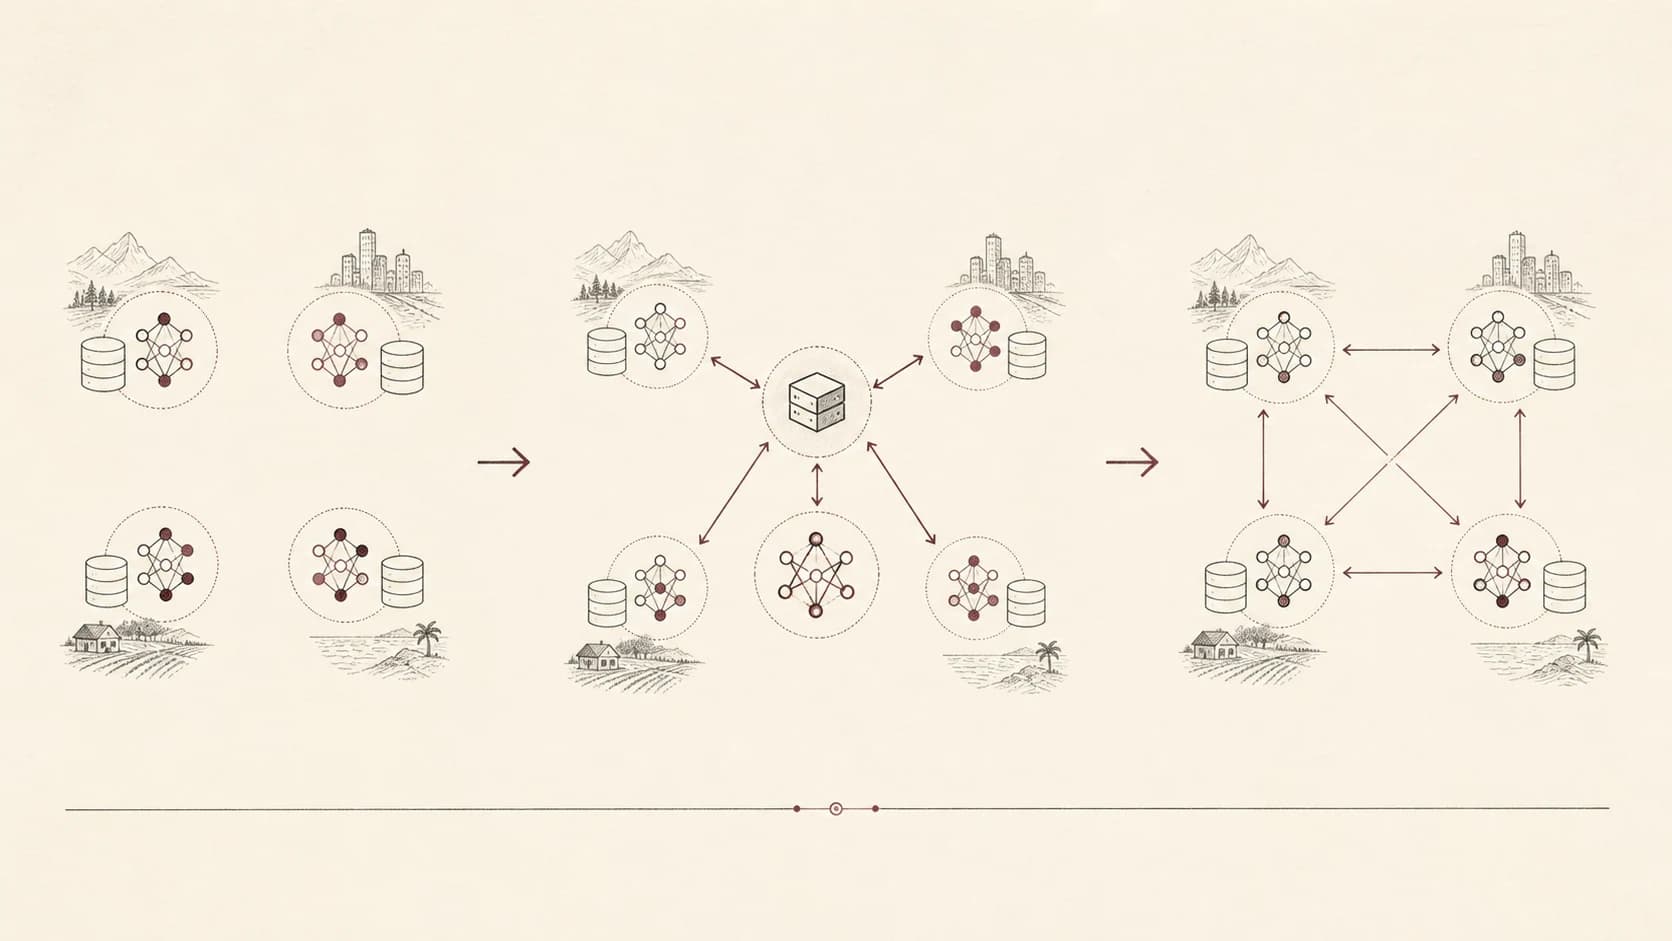
El esquema tradicional con un coordinador central puede convertirse en cuello de botella o punto único de fallo. Mi trabajo explora infraestructuras de aprendizaje federado descentralizado (DFL), donde los participantes colaboran mediante comunicación directa entre nodos o topologías semidescentralizadas.
Beneficios de este enfoque:
- Tolerancia a fallos: puede reducirse la dependencia de un agregador, aunque la conectividad y otros servicios siguen condicionando la disponibilidad.
- Escalabilidad: la incorporación y retirada requieren un protocolo de membresía y control de convergencia.
- Privacidad: se reduce la concentración de actualizaciones en una única entidad.
Ciberseguridad en dispositivos IoT
En proyectos como DEFENDIS, FL puede apoyar estrategias para identificar amenazas en dispositivos IoT:
- Device fingerprinting: identificación mediante huellas de hardware y comportamiento.
- Detección continua de anomalías: modelos locales que detectan desviaciones en sensores o gateways.
- Seguridad distribuida: arquitecturas donde la defensa no depende de una única entidad central.
Privacidad en aprendizaje federado
También exploro mecanismos no intrusivos para reducir exposición de datos personales u organizacionales:
- Local Differential Privacy (LDP).
- Secure Multi-Party Computation (SMPC).
- FL combinado con garantías de privacidad diferencial.
Líneas de trabajo futuras
La evolución del Federated Learning se está moviendo hacia varias líneas relevantes:
1. El Aprendizaje Federado a nivel de Borde (Edge AI)
Con la expansión del edge computing, los modelos podrán adaptarse en móviles, sensores, gateways y equipos autónomos sin enviar datos brutos a la nube.
2. Aprendizaje federado entre organizaciones (Cross-Silo FL)
Organizaciones con restricciones legales o competitivas pueden colaborar mediante federaciones cross-silo, compartiendo aprendizaje sin exponer datos brutos.
3. Grandes Modelos de Lenguaje (LLMs) y FL
FL puede ser relevante para adaptar o evaluar modelos grandes en entornos donde los datos no pueden centralizarse, especialmente si se combina con técnicas de eficiencia, privacidad y control de calidad de actualizaciones.
4. Modelos fundacionales
La combinación de modelos fundacionales con entrenamiento o adaptación federada puede habilitar personalización manteniendo datos locales. Proteger las actualizaciones y limitar inferencias requiere mecanismos adicionales y evaluación.
Cómo empezar con aprendizaje federado
Si quieres experimentar con FL, estos recursos son buenos puntos de partida:
Empieza con un experimento local reproducible. La guía de NEBULA enlaza a la documentación oficial y explica qué detalles de configuración conservar.
Recursos de aprendizaje
- Papers fundacionales: por ejemplo, Communication-Efficient Learning of Deep Networks from Decentralized Data y trabajos recientes sobre DFL.
- Tutoriales prácticos: muchos frameworks ofrecen notebooks y guías paso a paso.
- Conferencias y workshops: ICML, NeurIPS y talleres específicos de FL, privacidad y aprendizaje distribuido.
Un ejemplo numérico de FedAvg y sus límites
Supón dos clientes con 20 y 80 ejemplos que devuelven un parámetro escalar de 1.0 y 3.0. El promedio ponderado es 2.6, mientras que dar el mismo peso a cada cliente produce 2.0. Ninguno de esos números es un resultado experimental: muestran que el objetivo depende de la ponderación.
El pseudocódigo anterior ilustra únicamente agregación y presupone nombres de parámetros compatibles. No implementa selección de clientes, autenticación ni protección criptográfica. FedAvg combina modelos obtenidos tras entrenamiento local, que puede contener varios pasos; no es idéntico en general a promediar un único gradiente global. La referencia original es McMahan y colaboradores, AISTATS 2017.
¿Mantener los datos locales garantiza privacidad?
No. Deep Leakage from Gradients muestra reconstrucción de datos a partir de gradientes en condiciones experimentales específicas. No significa que toda actualización permita recuperar todo el conjunto; demuestra que el intercambio merece un modelo de amenaza.
Distingue confidencialidad del transporte, ocultación de contribuciones individuales y limitación de inferencias sobre personas o dispositivos. La agregación segura y la privacidad diferencial aplicada a entrenamiento abordan aspectos distintos. Ninguna selección de arquitectura permite afirmar cumplimiento normativo automático.
Cómo saber si la colaboración compensa
Reserva dispositivos o instituciones completas para test cuando quieras medir transferencia. Compara el modelo federado con modelos locales usando el mismo presupuesto de ajuste. Informa de resultados por cliente y de quién pierde calidad después de colaborar. Si las etiquetas tienen significados distintos entre organizaciones, una media global puede ocultar un problema de definición de tarea.
La distinción entre horizontal y vertical describe cómo se reparten muestras y características; centralizado y descentralizado describen coordinación. Son ejes diferentes. Para profundizar, consulta los fundamentos de DFL y la interacción entre privacidad y robustez.
Conclusión
El aprendizaje federado no elimina todos los riesgos de privacidad, pero cambia una premisa importante: permite colaborar en entrenamiento y evaluación sin convertir la centralización de datos brutos en la opción por defecto. Su valor real aparece cuando se combina con seguridad, privacidad diferencial, agregación robusta y una evaluación honesta de las amenazas del sistema. Para mi trabajo, la parte más interesante aparece cuando FL se cruza con seguridad, descentralización y aprendizaje automático confiable.
Si trabajas en aprendizaje federado, sistemas con preservación de privacidad o aplicaciones de ciberseguridad, estoy abierto a discutir problemas de investigación relacionados.
Este post se enmarca en mi línea de investigación sobre aprendizaje federado, privacidad y seguridad, iniciada durante el doctorado y continuada en mi etapa postdoctoral. Para una visión más formal, puedes revisar también la sección de publicaciones académicas.