En este artículo
Financiado por: Fundación Séneca (Agencia de Ciencia y Tecnología de la Región de Murcia)
Beca: 21629/FPI/21
El Aprendizaje Federado Descentralizado (DFL)1 es útil en escenarios donde varios participantes necesitan entrenar modelos de forma conjunta, pero los datos brutos deben permanecer en local. A diferencia del aprendizaje federado centralizado, DFL reduce la dependencia de un único coordinador y desplaza parte de la lógica de colaboración a los propios participantes de la red.
El DFL es un sistema federado en el cual las comunicaciones están descentralizadas entre los participantes de una red. Esto puede reducir el riesgo de un punto único de fallo, bajar ciertos costes de comunicación, mejorar la escalabilidad y disminuir la dependencia de una autoridad central.
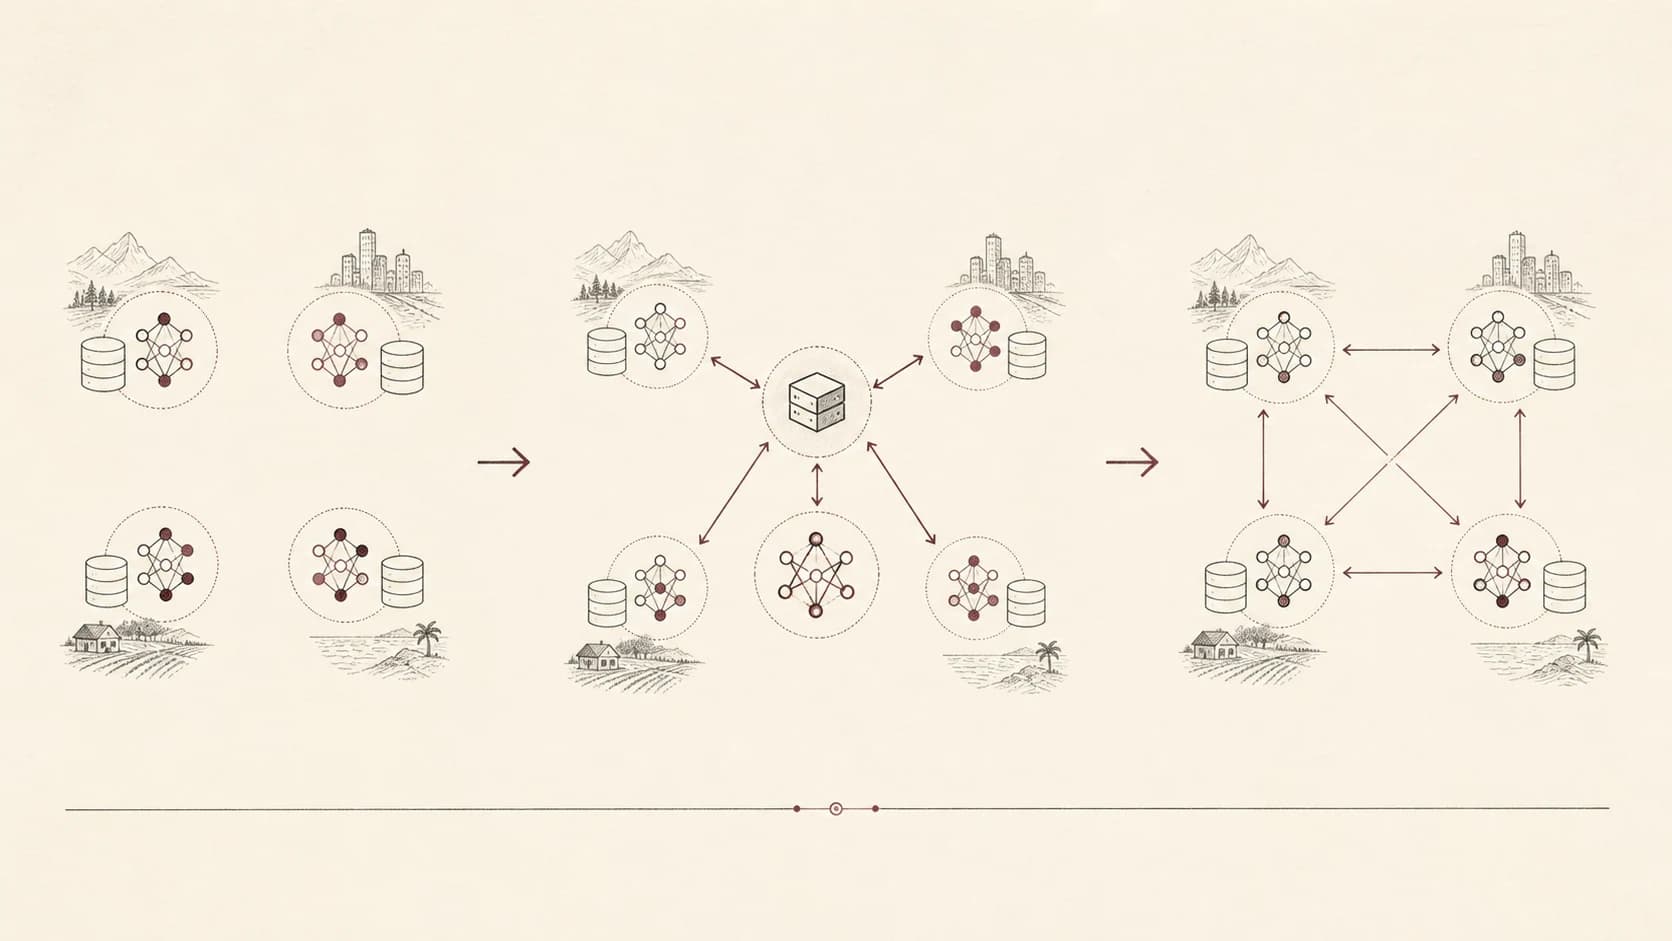
El DFL también introduce desafíos que conviene estudiar con cuidado. En el centro está la pregunta de cómo entrenar de forma colaborativa preservando privacidad y manteniendo robustez. Al revisar i) arquitecturas DFL, ii) componentes, iii) topologías, iv) protocolos de comunicación y v) métodos de seguridad, se entienden mejor sus mecanismos y compromisos.
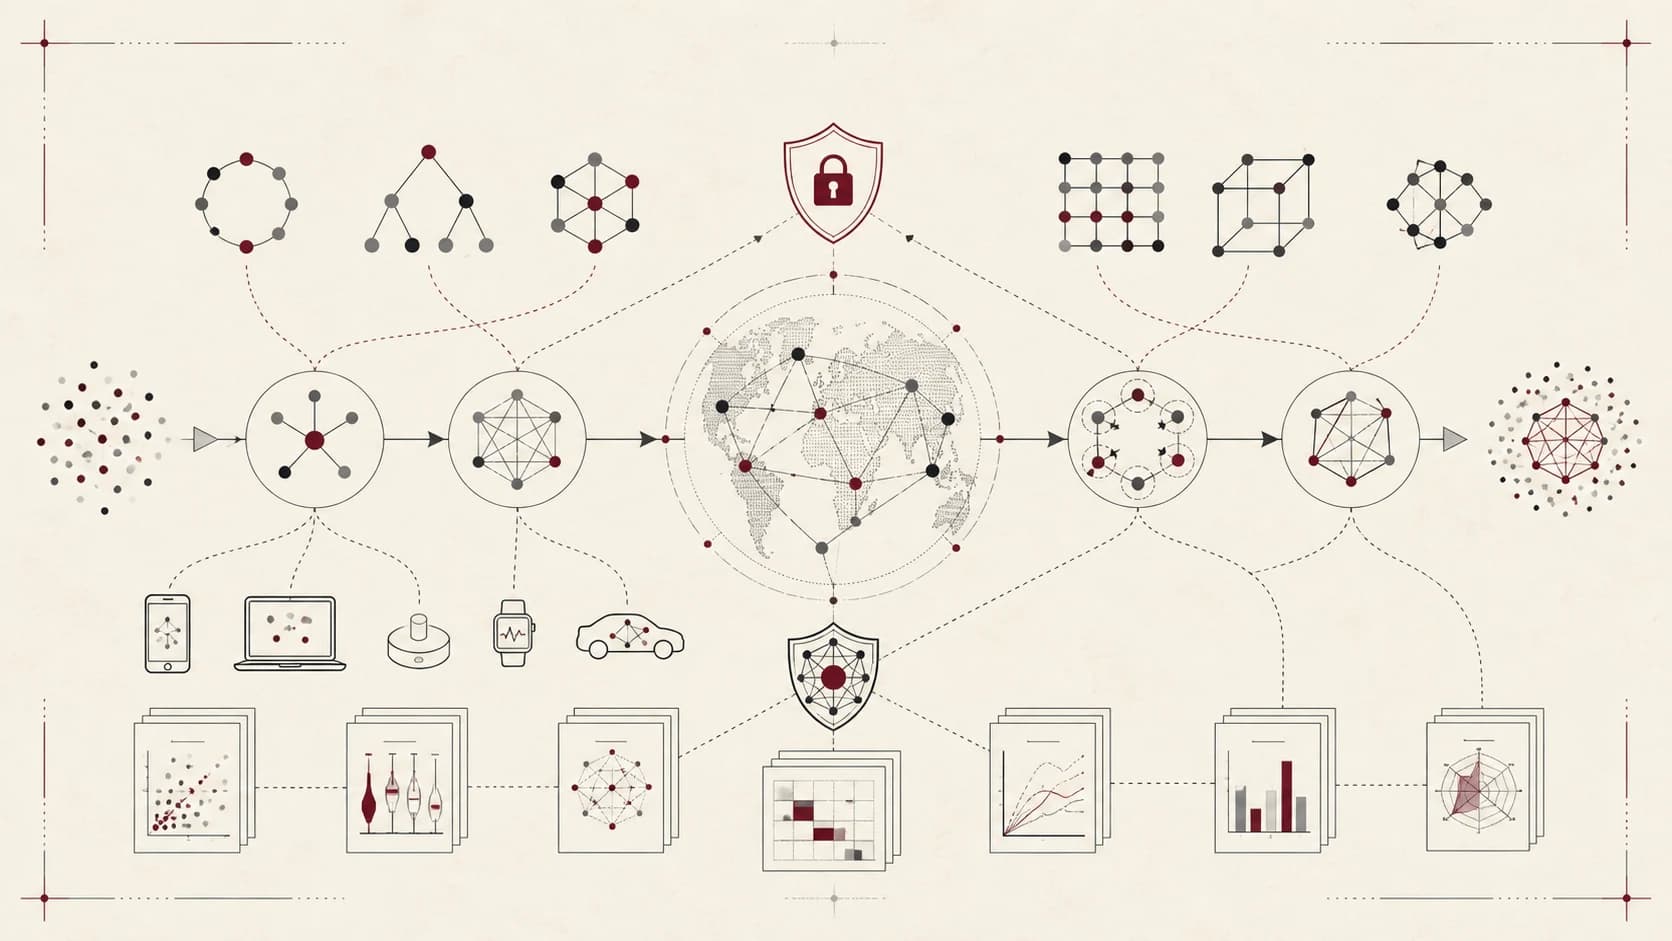
Además, se abordan aspectos de gestión de confianza y estrategias de optimización, incluyendo selección de algoritmos y evaluación de rendimiento. Después se revisan aplicaciones de DFL en sectores como salud, fabricación, servicios móviles, sistemas militares y vehículos, donde la descentralización puede ser útil cuando los datos no deberían moverse a un servidor central.
Fundamentos Matemáticos del DFL
Agregación Descentralizada
En DFL, el proceso de agregación está distribuido por toda la red. Una formulación descentralizada común puede ser expresada como:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.Donde:
- son los parámetros del modelo en el nodo
ien la iteraciónt. - es el conjunto de vecinos del nodo
i. - es el peso de la conexión entre los nodos
iyj. - es la tasa de aprendizaje (learning rate).
- es el gradiente de la función de pérdida local.
Qué permite hablar de convergencia
La ecuación anterior ilustra un paso de mezcla seguido de descenso para minimizar una pérdida; la vecindad incluye al propio nodo y los pesos suman uno por fila. No es una garantía universal para redes neuronales. La convergencia depende de suavidad de la pérdida, ruido del gradiente, heterogeneidad, tasas de aprendizaje y conectividad a lo largo del tiempo. Una matriz estocástica por filas preserva combinaciones convexas, pero no necesariamente el promedio uniforme de clientes.
El análisis de Koloskova y colaboradores, ICML 2020 trata topologías cambiantes y pasos locales bajo supuestos explícitos. Para un algoritmo concreto hay que comprobar qué objetivo converge, con qué pesos y bajo qué condiciones de red.
Arquitectura y Componentes del DFL
Topología de Red
Las redes DFL pueden organizarse en diversas topologías:
- Topología de Anillo: Patrón de comunicación secuencial.
- Topología de malla completa: Comunicación de todos con todos.
- Topología de Estrella: Comunicación entre concentradores (hub-and-spoke).
- Grafo Aleatorio: Conexiones probabilísticas.
Seguridad y Privacidad en DFL
Técnicas de Preservación de Privacidad
DFL puede combinarse con mecanismos de privacidad; no son propiedades inherentes del paradigma:
- Privacidad Diferencial: Adición de ruido calibrado a los gradientes.
- Agregación Segura: Protocolos criptográficos para la agregación del modelo.
- Cifrado Homomórfico: Computación sobre datos encriptados.
- Pruebas de Conocimiento Cero (Zero-Knowledge Proofs): Verificación de cálculos sin revelar los datos de origen.
Detección de Ciberataques con DFL
Otro escenario de aplicación es en la detección de ciberataques. A medida que los ciberataques se vuelven más frecuentes y sofisticados, la detección resulta ser un reto cada vez mayor. DFL podría permitir a una red de computadoras entrenar un modelo de ML para identificar patrones de comportamiento sospechosos con datos locales y coordinación descentralizada. El beneficio en privacidad y detección debe demostrarse para cada protocolo; la localidad de datos no basta.
Aplicaciones y criterios de diseño
En salud, el reto incluye diferencias entre poblaciones, equipos y criterios de etiquetado. Mantener los registros locales no valida un uso clínico. Una prueba de investigación debe medir transferencia entre centros y calidad por subgrupo, con controles específicos de acceso y privacidad.
En industria, varios centros pueden aprender sobre anomalías sin centralizar todas sus trazas. Hay que separar cronológicamente entrenamiento y test, y distinguir mantenimiento autorizado, fallos y ataques. La inferencia local puede continuar durante una desconexión aunque el entrenamiento colaborativo se pause.
En dispositivos móviles y vehículos, participación y conectividad varían. Una política que solo acepta clientes rápidos puede sesgar el modelo hacia los dispositivos con mejores recursos. Evalúa quién queda fuera y cómo se recupera un nodo después de una ausencia.
Contabilizar la comunicación real
Enviar un tensor denso lleno de ceros no equivale a comprimirlo. Una implementación dispersa debe serializar índices y valores, incluir metadatos y medir bytes realmente transmitidos. La frecuencia de intercambio también importa: menos bytes por mensaje puede acompañarse de más rondas.
La investigación sobre gossip con comunicación comprimida muestra por qué hay que analizar conjuntamente compresión y dinámica de consenso. Para experimentar, fija primero una calidad objetivo y compara tiempo y bytes acumulados hasta alcanzarla. Si un método nunca alcanza el objetivo, conserva ese fallo en el resultado.
Confianza y admisión de participantes
Una media móvil de reputación puede suavizar señales, pero no demuestra que un nodo sea honesto. Un cliente legítimo con datos raros puede parecer distante de sus vecinos. Define autenticación, límite de influencia, antigüedad máxima y recuperación, y mide rechazos erróneos en ausencia de ataque.
El protocolo también necesita una política cuando no quedan suficientes vecinos válidos. Continuar localmente, posponer la mezcla o pedir intervención son opciones que deben quedar visibles. No renormalices silenciosamente una contribución adversaria hasta darle todo el peso disponible.
Líneas de investigación que pueden ponerse a prueba
Tres preguntas concretas conectan los fundamentos con la experimentación actual: cómo afectan admisión y reincorporación a la convergencia; si los mecanismos de privacidad cambian los falsos rechazos de una defensa robusta; y cuándo intercambiar prototipos reduce realmente los bytes necesarios para una calidad objetivo. Cada pregunta requiere referencias comparables y medidas por cliente.
La guía de privacidad y robustez desarrolla la segunda pregunta, y la nota sobre comunicación con prototipos desarrolla la tercera.
¿Cuándo elegir DFL frente a FL con servidor?
Elige por el requisito de coordinación. Un consorcio con un coordinador aceptado puede obtener un diseño más sencillo con FL centralizado. Una red con pares autónomos y restricciones de conectividad puede justificar DFL, siempre que exista conectividad suficiente para la colaboración prevista. Una topología en estrella sigue concentrando dependencia en su centro, aunque los datos permanezcan distribuidos.
Como prueba de decisión, escribe qué servicio debe sobrevivir si desaparece el coordinador: inferencia, intercambio, entrenamiento o incorporación de miembros. Son propiedades distintas. A continuación, ejecuta ese fallo y comprueba el comportamiento observado, en vez de inferirlo del nombre de la arquitectura.
Esta guía se apoya en la revisión de DFL de 2023. Para continuar, la guía de diseño de sistemas DFL convierte esas decisiones en un protocolo, y NEBULA ofrece un punto de partida experimental.
Conclusión
El Aprendizaje Federado Descentralizado es una línea práctica para entrenar modelos de forma colaborativa cuando privacidad, seguridad y descentralización son requisitos importantes. Su valor depende de detalles concretos: topología, agregación, coste de comunicación, robustez y modelo de amenaza.
Conclusiones principales:
- DFL permite aprendizaje colaborativo con datos locales.
- La trazabilidad requiere registros autenticados y un modelo explícito de gobernanza.
- La detección de ciberataques puede beneficiarse de observaciones distribuidas.
- Salud, industria y sistemas móviles son dominios donde el enfoque puede tener sentido.
- La comunicación sigue siendo un punto crítico para que un diseño DFL sea útil en la práctica.
Un resultado útil en DFL declara qué dependencia se ha reducido, qué participantes se han beneficiado y qué costes o modos de fallo permanecen.
Footnotes
-
Martinez Beltrán, E. T., Quiles Pérez, M., Sánchez Sánchez, P., López Bernal, S., Bovet, G., Gil Pérez, M., Martínez Pérez, G., & Huertas Celdrán, A. (2023). Decentralized Federated Learning: Fundamentals, State of the Art, Frameworks, Trends, and Challenges. IEEE Communications Surveys & Tutorials doi: 10.1109/COMST.2023.3315746 ↩