En este artículo
La robustez en aprendizaje federado descentralizado debería medirse como respuesta a unas condiciones, no como una cifra aislada del experimento. Un modelo puede mantener un F1 alto mientras empeoran las comunicaciones, se saturan los recursos o un participante comienza a enviar actualizaciones envenenadas. Una buena evaluación hace visibles todas esas dimensiones.
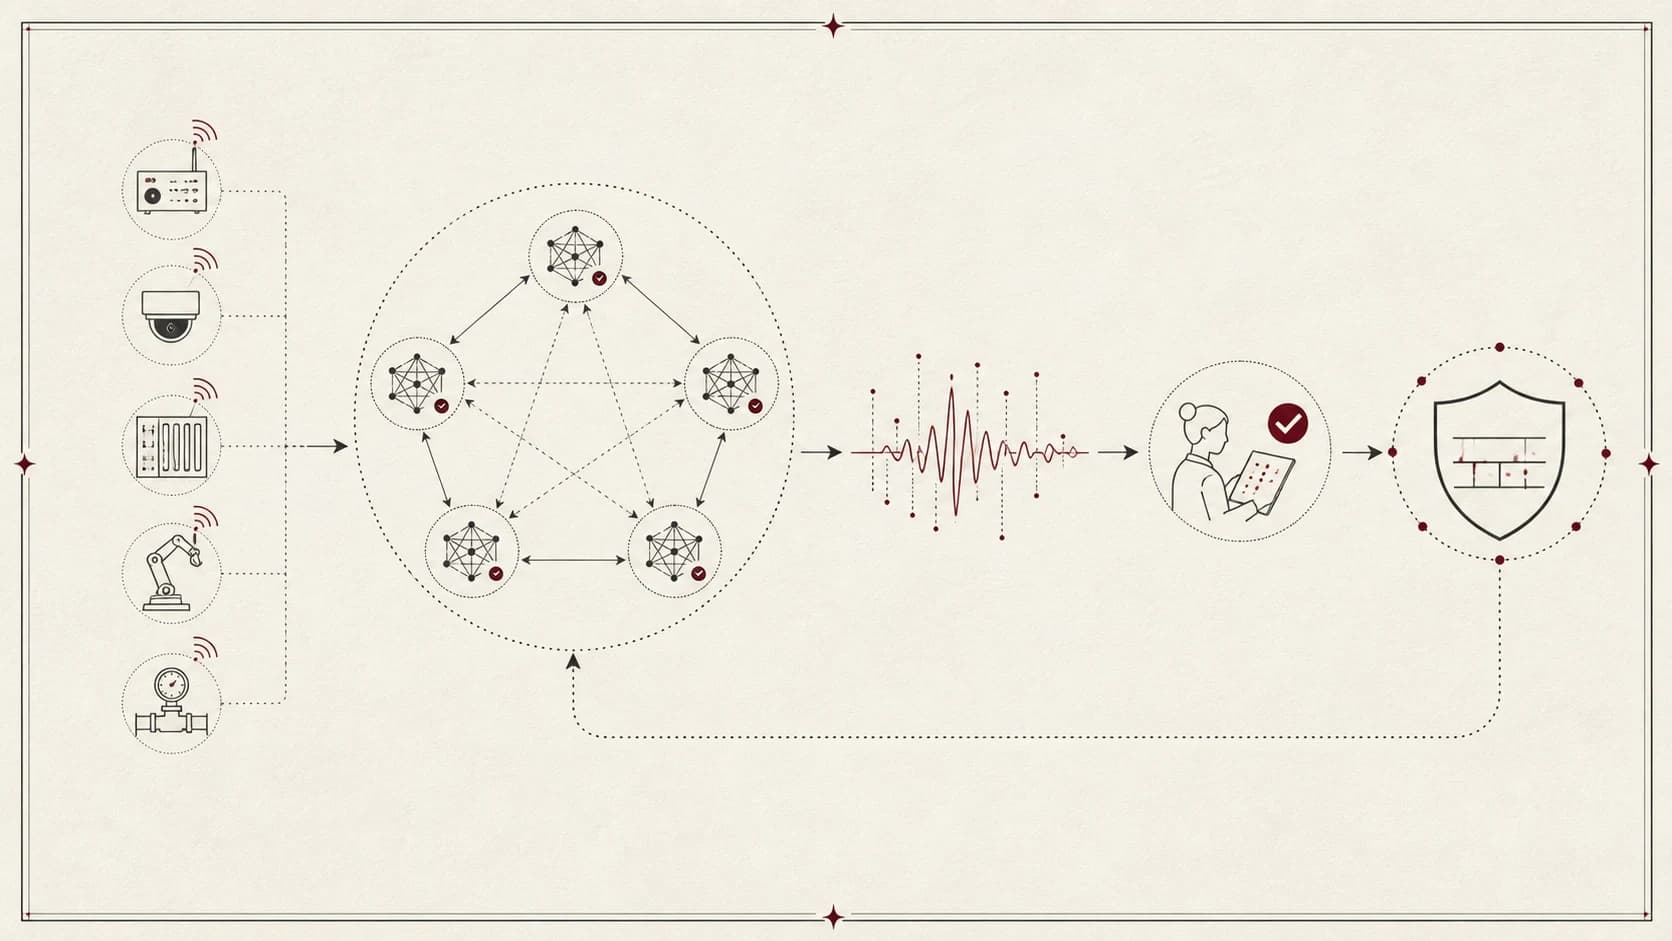
Los experimentos de Flighter ofrecen una plantilla útil. Cuatro aeronaves simuladas equipadas con radar de apertura sintética colaboran en reconocimiento con VGG16, usando MSTAR, SAMPLE y OpenSARShip. El escenario incluye una línea base y varias perturbaciones operativas o adversarias. El valor de estos resultados está precisamente en que su alcance está definido.
Empezar por las métricas de tarea
Para una decisión binaria o one-vs-rest, las cantidades habituales son:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.y:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.F1 es útil cuando importan tanto falsos positivos como falsos negativos, pero no describe la salud de la federación. Hay que leerlo junto a las medidas de red y de sistema.
Establecer una línea base reproducible
En las condiciones de referencia comunicadas para los tres conjuntos de datos, el estudio obtiene valores F1 del 95,8% para MSTAR, 97,5% para SAMPLE y 79,1% para OpenSARShip. No son una clasificación universal de los conjuntos ni una garantía para un despliegue. Son puntos de comparación para estudiar cuánto rendimiento se pierde cuando el entorno se altera.
La misma línea base registra aproximadamente un 57% de uso de CPU, 1,7 GB de RAM, un 0,7% de pérdida de paquetes y rondas de 5,3 segundos. Informar de estas cifras evita una comparación engañosa en la que el método de defensa parece mejor porque su coste de recursos queda oculto.
Perturbar el sistema de varias formas
La tesis distingue varias familias de estrés:
Manipulación del contexto
Cuando se manipula el geoposicionamiento, los valores F1 comunicados son 91,8% para MSTAR, 90,3% para SAMPLE y 72,0% para OpenSARShip. La pérdida de paquetes permanece por debajo del 1% en el experimento descrito. Este caso comprueba si el contexto operativo puede reducir el efecto de un nodo cuyo comportamiento ya no encaja con la misión.
Comportamiento de curso de colisión
En la manipulación de curso de colisión, los valores correspondientes son 92,5%, 89,8% y 70,1%. La reducción no es igual en todos los conjuntos, recordando que un mecanismo robusto interactúa con la distribución de datos y la dificultad de la tarea.
Poisoning
En los escenarios de poisoning, F1 oscila entre 52,1% y 90,1% según el conjunto de datos y la configuración del ataque. Un intervalo es más informativo que un promedio único porque muestra que el mismo protocolo puede comportarse de forma muy diferente cuando cambian los datos locales y la estrategia adversaria.
Usar una matriz de medición
Un informe compacto puede combinar estos ejes:
| Eje | Qué registrar | Por qué importa |
|---|---|---|
| Calidad predictiva | F1, precision, recall y matriz de confusión | Muestra el efecto en la tarea |
| Colaboración | tiempo de ronda, entrega de mensajes y participación | Expone la salud del protocolo |
| Recursos | CPU, memoria y proxy de energía | Comprueba la viabilidad |
| Robustez | poisoning, manipulación de contexto y vecinos retrasados | Prueba las hipótesis de amenaza |
| Equidad | rendimiento por cliente o por clase | Detecta fallos locales ocultos |
La última fila es especialmente importante en entornos heterogéneos. Un F1 global puede permanecer estable mientras un cliente o una clase minoritaria pierde casi todo su recall. La robustez debería incluir la distribución de resultados, no solo la media.
Interpretar sin exagerar
Tres preguntas hacen más honesta una evaluación:
- ¿Qué se mantuvo fijo? Conjunto de datos, modelo, grafo, número de clientes y presupuesto de ataque afectan al resultado.
- ¿Qué cambió? Una comparación solo tiene sentido si defensa y línea base comparten condiciones de entrenamiento y comunicación.
- ¿Qué falta todavía? Una simulación no establece el comportamiento con sensores, movilidad y fallos reales, ni ante un ataque desconocido.
Por tanto, el estudio Flighter se entiende mejor como una demostración controlada de evaluación entre capas. Conecta rendimiento del modelo y señales situacionales, y ofrece una forma concreta de hablar de influencia reducida, límites de conexión y recuperación. El siguiente paso no es publicar un porcentaje mayor, sino comprobar si los indicadores siguen siendo útiles cuando también son ruidosos, llegan tarde o han sido manipulados.
Protocolo de experimento reutilizable
Para una nueva defensa DFL conviene publicar:
- la línea base limpia,
- el grafo y la política de participación,
- el modelo de ataque y perturbación,
- métricas predictivas y de sistema por condición,
- intervalos de confianza o repeticiones,
- la sobrecarga de recursos de la defensa,
- el comportamiento de fallo y recuperación.
Ese nivel de detalle convierte robustez, de adjetivo de marketing, en una propiedad auditable del sistema.
Diferencia absoluta y mejora relativa
Una variación de F1 de 0.80 a 0.84 equivale a cuatro puntos porcentuales y a una mejora relativa del 5%. Es un ejemplo aritmético, no un resultado de Flighter. Explica siempre qué convención usa una comparación y si el F1 es macro, micro o ponderado.
Las cifras de las secciones anteriores corresponden al estudio Flighter y a su configuración descrita. No deben combinarse con resultados de otra topología o presupuesto como si fueran una comparación controlada.
Separar ataque y coste de defensa
Propongo una matriz de cuatro condiciones: sin ataque y sin defensa, sin ataque con defensa, con ataque sin defensa y con ataque y defensa. Usa el mismo reparto de datos y semillas para comparar diferencias pareadas. Así puedes distinguir mejora bajo ataque de penalización en condiciones normales.
Incluye un adversario con presupuesto declarado y una condición de cliente legítimo muy heterogéneo. Cuenta falsos rechazos, recuperación después del ataque y degradación del peor cliente. Si se excluyen ejecuciones que no convergen, el informe pierde precisamente parte de la evidencia de robustez.
Incertidumbre con unidades independientes
Los clientes de una misma federación no son réplicas independientes: comparten actualizaciones. Usa ejecuciones independientes como unidad al resumir variabilidad y conserva resultados por cliente como análisis interno. Publica semillas, duración de ataque y regla de parada.
El análisis de Yang y colaboradores, ICML 2025 justifica prestar atención a la calidad sin ataque. Para ampliar el diseño experimental, consulta limitaciones y preguntas abiertas de DFL y agregación bizantina.