En este artículo
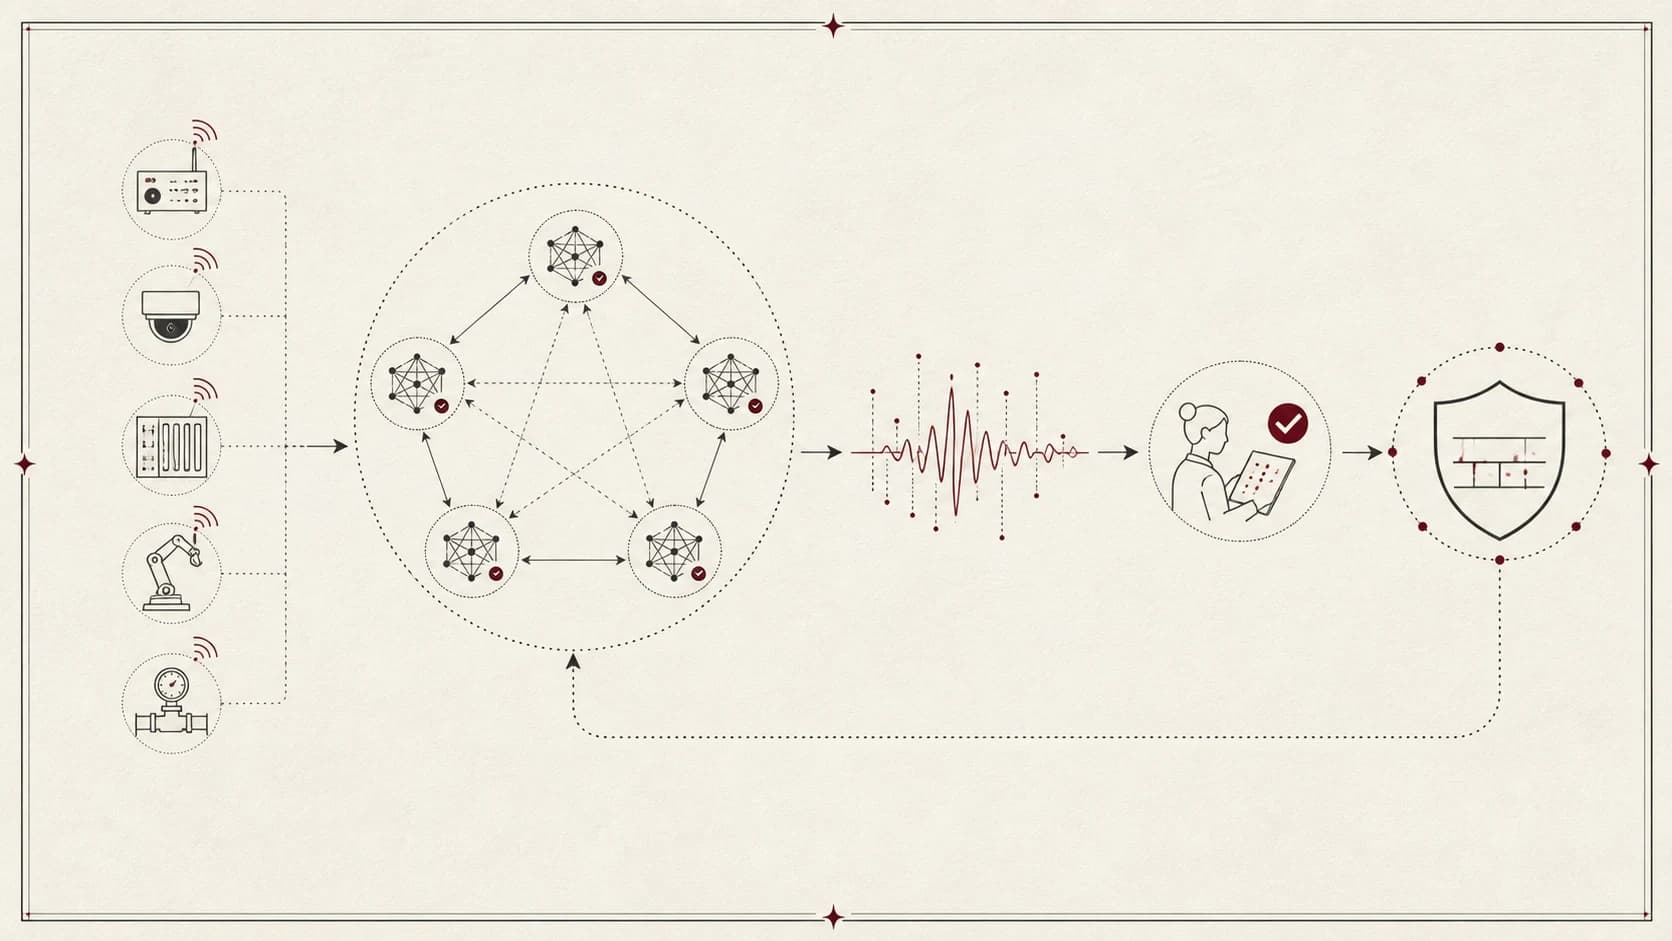
La ciberdefensa no termina cuando un modelo predice una anomalía. Un sistema útil necesita un ciclo: monitorizar el entorno, entrenar o actualizar modelos, ejecutar inferencia, detectar alertas, explicar la situación, recomendar mitigaciones y devolver el resultado al siguiente ciclo de entrenamiento.
Ahí es donde el aprendizaje federado descentralizado empieza a ser útil más allá de la fase de entrenamiento.
1. Monitorización
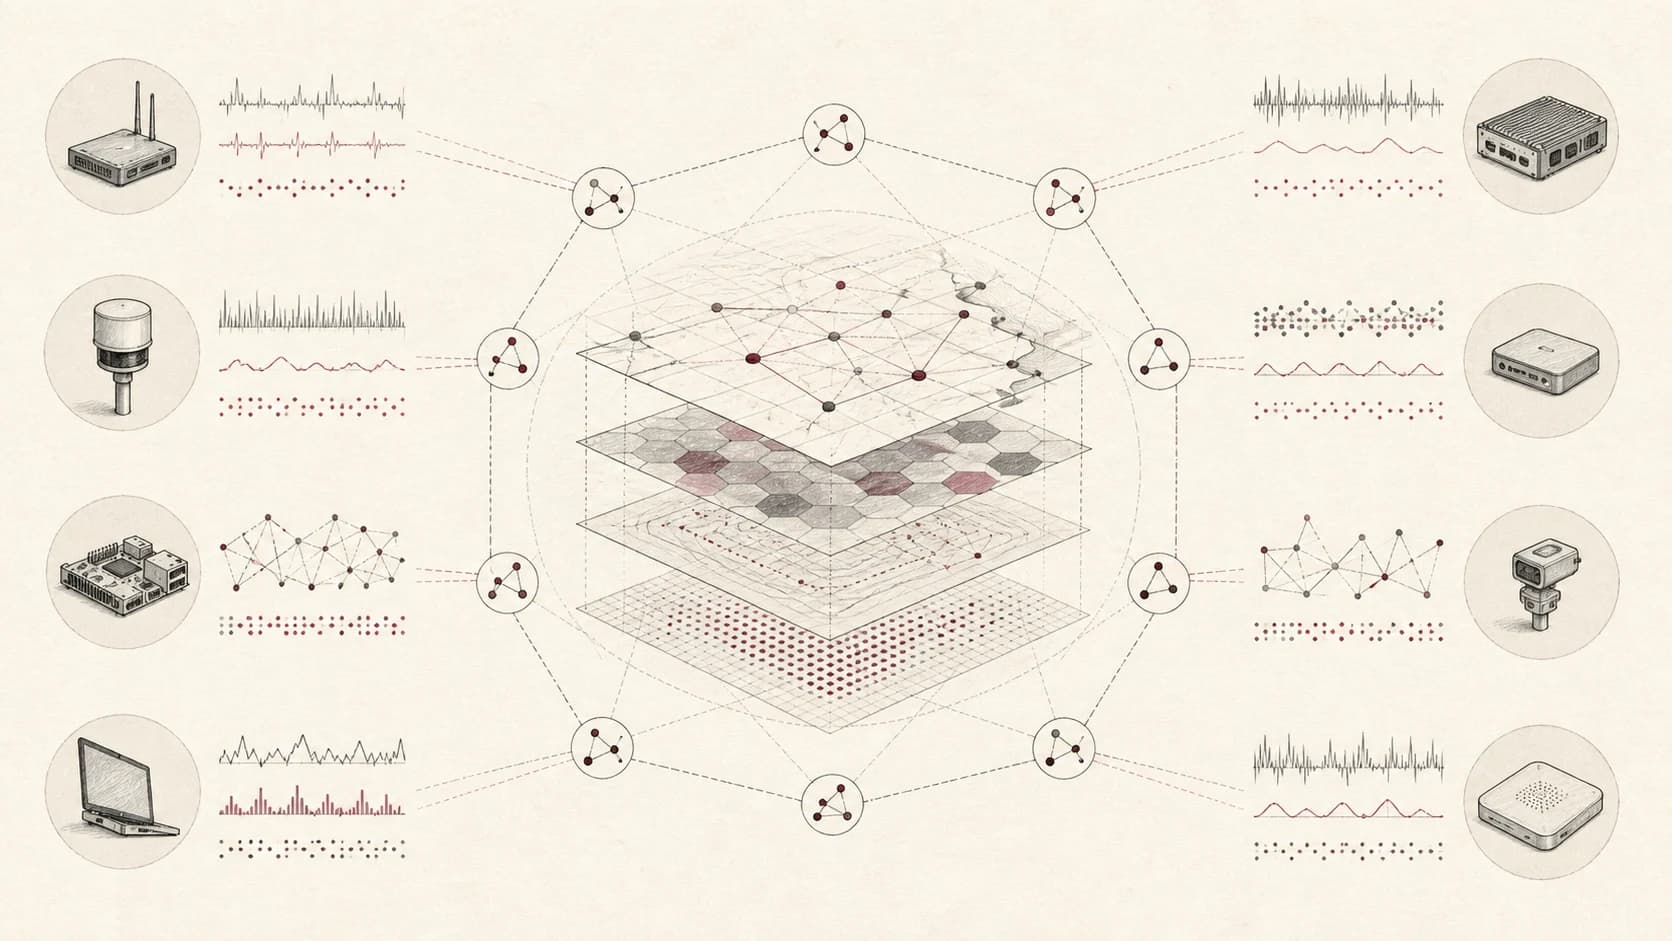
La primera capa es la monitorización distribuida. Nodos edge, sensores, funciones de red, drones, gateways IoT o controladores industriales observan comportamiento local y generan telemetría. La restricción importante es que no todos los participantes pueden o deben centralizar datos brutos.
La monitorización debería recoger estructura suficiente para apoyar decisiones de seguridad:
- indicadores de anomalía,
- marcas temporales,
- contexto local,
- confianza del modelo,
- señales de confianza entre peers,
- resultado de mitigaciones.
2. Entrenamiento federado
En lugar de enviar toda la telemetría a un repositorio central, cada participante entrena localmente y comparte actualizaciones acotadas del modelo. En DFL, la agregación puede ocurrir directamente entre nodos vecinos o mediante topologías semidescentralizadas, eliminando una dependencia central única.
La pregunta de seguridad no es solo la precisión. El sistema debe gestionar poisoning, actualizaciones retrasadas, peers no fiables y datos locales non-IID.
3. Inferencia y detección de alertas
La inferencia debería ejecutarse cerca del entorno monitorizado cuando la latencia importa. Las alertas deberían incluir score del modelo, contexto local y evidencia que provocó la escalada.
Una alerta es débil si solo dice "ataque". Es más fuerte cuando indica:
- qué cambió,
- dónde cambió,
- qué confianza tiene el modelo,
- si otros peers ven patrones similares,
- qué mitigaciones están disponibles.
4. Uso de LLMs para apoyar la mitigación
Los LLMs no deberían sustituir al detector ni ejecutar acciones defensivas por sí solos. Un papel más realista es situarlos después de la detección para convertir evidencia técnica en una explicación del ataque, algunas hipótesis plausibles y opciones de mitigación para un operador.
Una capa LLM útil debería recibir contexto de seguridad estructurado, no prompts vagos. Puede producir:
- resumen en lenguaje claro,
- hipótesis probables de ataque,
- caveats de confianza,
- acciones de mitigación recomendadas,
- enlaces a playbooks,
- preguntas para el analista humano.
Un paquete mínimo de evidencia podría tener esta forma:
Ventana de telemetría -> inferencia DFL local -> score de anomalía
  -> comprobaciones de acuerdo entre peers y deriva
  -> paquete de evidencia: activo, ventana temporal, síntomas, confianza, restricciones
  -> explicación y opciones de mitigación apoyadas por un LLM
  -> aprobación o rechazo del analista
  -> resultado de mitigación registrado para el siguiente ciclo de aprendizaje
Por ejemplo, si varios nodos edge informan de ráfagas anómalas de autenticación e intentos de conexión lateral, el LLM no debería "decidir" la respuesta. Debería resumir la evidencia, relacionarla con etapas plausibles del ataque, sugerir opciones acotadas como aislar un segmento o aumentar la monitorización, y dejar la decisión al analista.
5. Mitigación y feedback
La mitigación debe ser explícita: bloquear, aislar, limitar tráfico, rotar claves, cambiar políticas, activar monitorización extra o seguir observando. Un LLM puede ayudar a explicar por qué una mitigación es plausible, qué evidencia la respalda y qué riesgo queda, pero la acción debería estar acotada por playbooks aprobados y supervisión humana. El resultado de esa mitigación vuelve como feedback al siguiente ciclo de entrenamiento y evaluación.
El objetivo no es un sistema autónomo opaco. El objetivo es un bucle trazable donde DFL aporta aprendizaje colaborativo, los modelos de detección aportan evidencia y los LLMs ayudan a humanos a entender el ataque y comparar mitigaciones con más rapidez.
Idea clave
El papel útil de los LLMs es concreto y operativo: traducir evidencia de seguridad estructurada en contexto comprensible del ataque y opciones de mitigación acotadas, mientras DFL y los modelos de detección siguen siendo responsables del aprendizaje y de la evidencia de alerta.
Pregunta abierta de investigación
¿Cómo evaluar estos pasos de mitigación apoyada por LLMs para asegurar que las explicaciones sean fieles a la evidencia y las recomendaciones permanezcan dentro de playbooks operativos aprobados?
Regla de diseño
Trata el LLM como apoyo para explicación y mitigación, no como autoridad de detección. Un ciclo práctico sería: telemetría -> modelo DFL -> evidencia de alerta -> explicación con LLM -> opciones de mitigación -> aprobación humana -> feedback.
Un contrato de evidencia entre detector y asistente
Propongo que cada alerta viaje con un identificador de incidente, versión del modelo, ventana temporal, identificadores de eventos, cobertura observada y estado de validación. El asistente recibe una vista autorizada de esos campos, no acceso indiscriminado a los registros. La explicación debe poder reconstruirse con el mismo conjunto de evidencias aunque cambie el modelo de lenguaje.
Un error frecuente es confundir puntuación y probabilidad. Un score de anomalía de 0.9 no significa necesariamente un 90% de probabilidad de ataque. Antes de traducirlo a lenguaje operativo, hay que conocer su calibración y el umbral usado. Si no existe calibración, preséntalo como puntuación del detector.
El feedback también necesita cuarentena
Una mitigación que hace desaparecer una alerta no demuestra que el diagnóstico fuera correcto: quizá desconectó el sensor. Separa resultado de acción, verificación del incidente y etiqueta para entrenamiento. Solo el tercer objeto debe entrar en la siguiente revisión de datos después de validarse.
Como prueba de laboratorio, reproduce un incidente con evidencia retrasada, una alerta duplicada y una corrección del analista. Comprueba que el sistema conserva una única identidad de incidente y no cuenta las copias como corroboraciones independientes. Mide trazabilidad completa y demora de revisión, además de F1.
NIST SP 800-61 Rev. 3 ofrece el marco de respuesta y recuperación. La revisión sistemática de LLMs para seguridad sitúa las capacidades del asistente en su contexto de investigación. El contrato anterior es una propuesta de integración, no un resultado empírico de esas fuentes.
Continúa con mitigación asistida por LLM y métricas de calidad y seguridad.