En este artículo
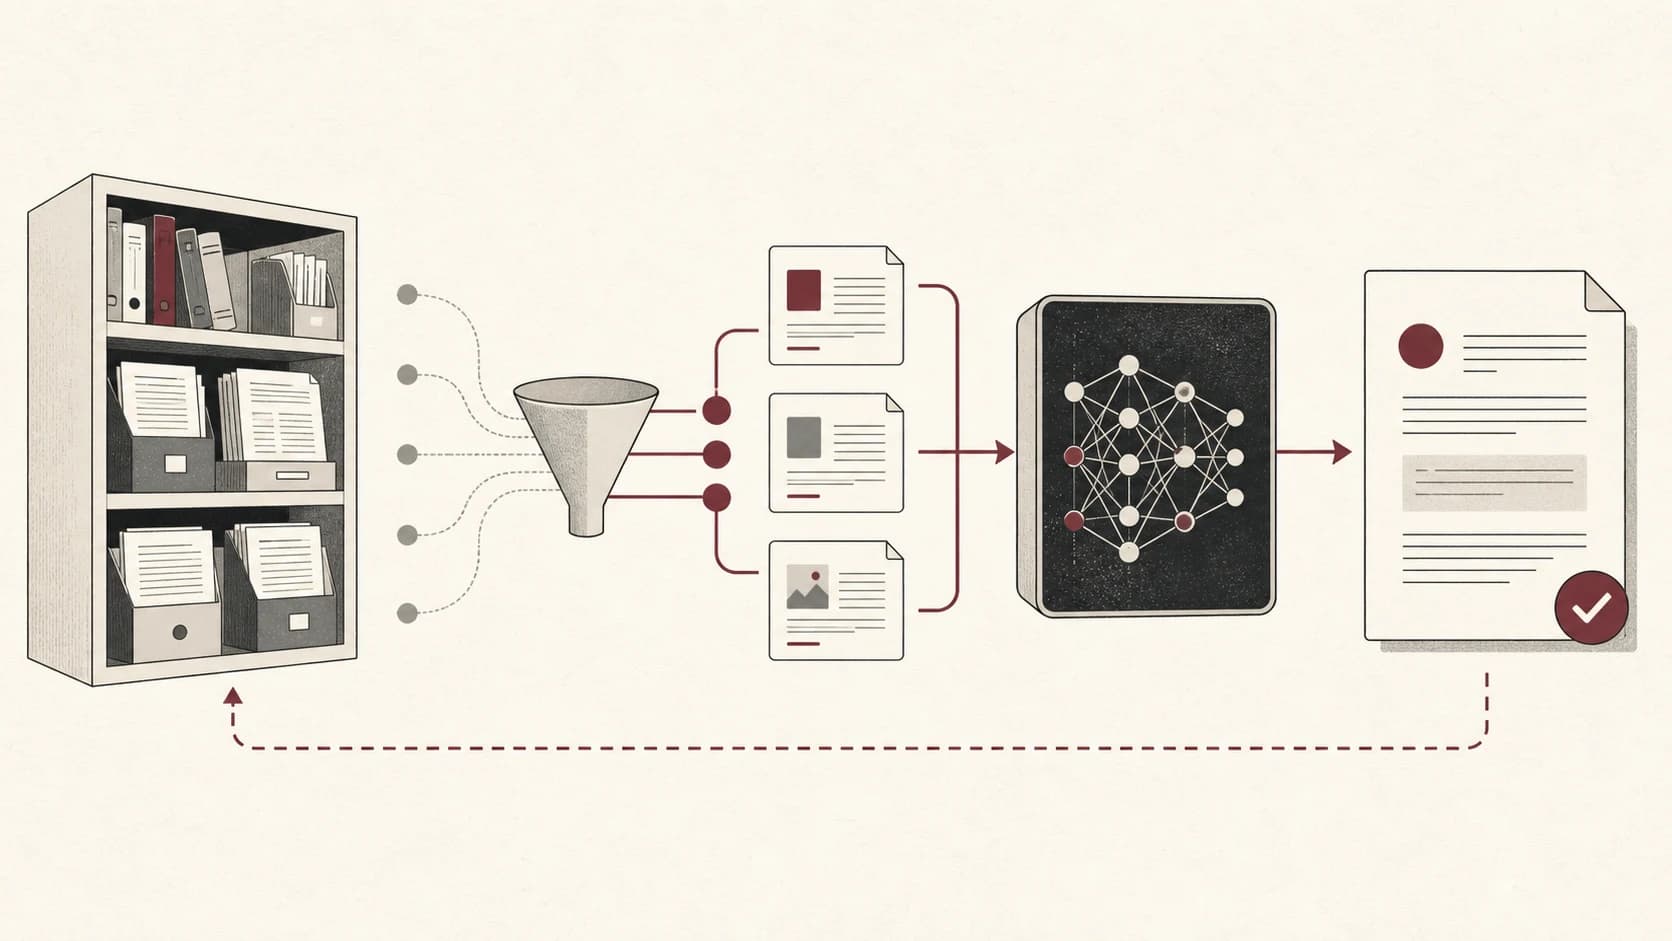
Retrieval-Augmented Generation, o RAG, combina un modelo de lenguaje con una colección externa de documentos. Esa colección puede contener playbooks, registros de vulnerabilidades, informes de incidentes o políticas locales. El modelo recibe un contexto seleccionado durante la inferencia y no depende solo de lo aprendido durante el preentrenamiento.
La idea es sencilla. La ingeniería no.
1. El flujo básico
Dada una consulta y una colección de documentos , un recuperador selecciona un contexto:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.Después, el generador produce una respuesta condicionada por la consulta y el contexto:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.La ecuación no garantiza que la respuesta esté respaldada. Solo describe de dónde recibió el contexto el modelo.
2. Qué importa en seguridad
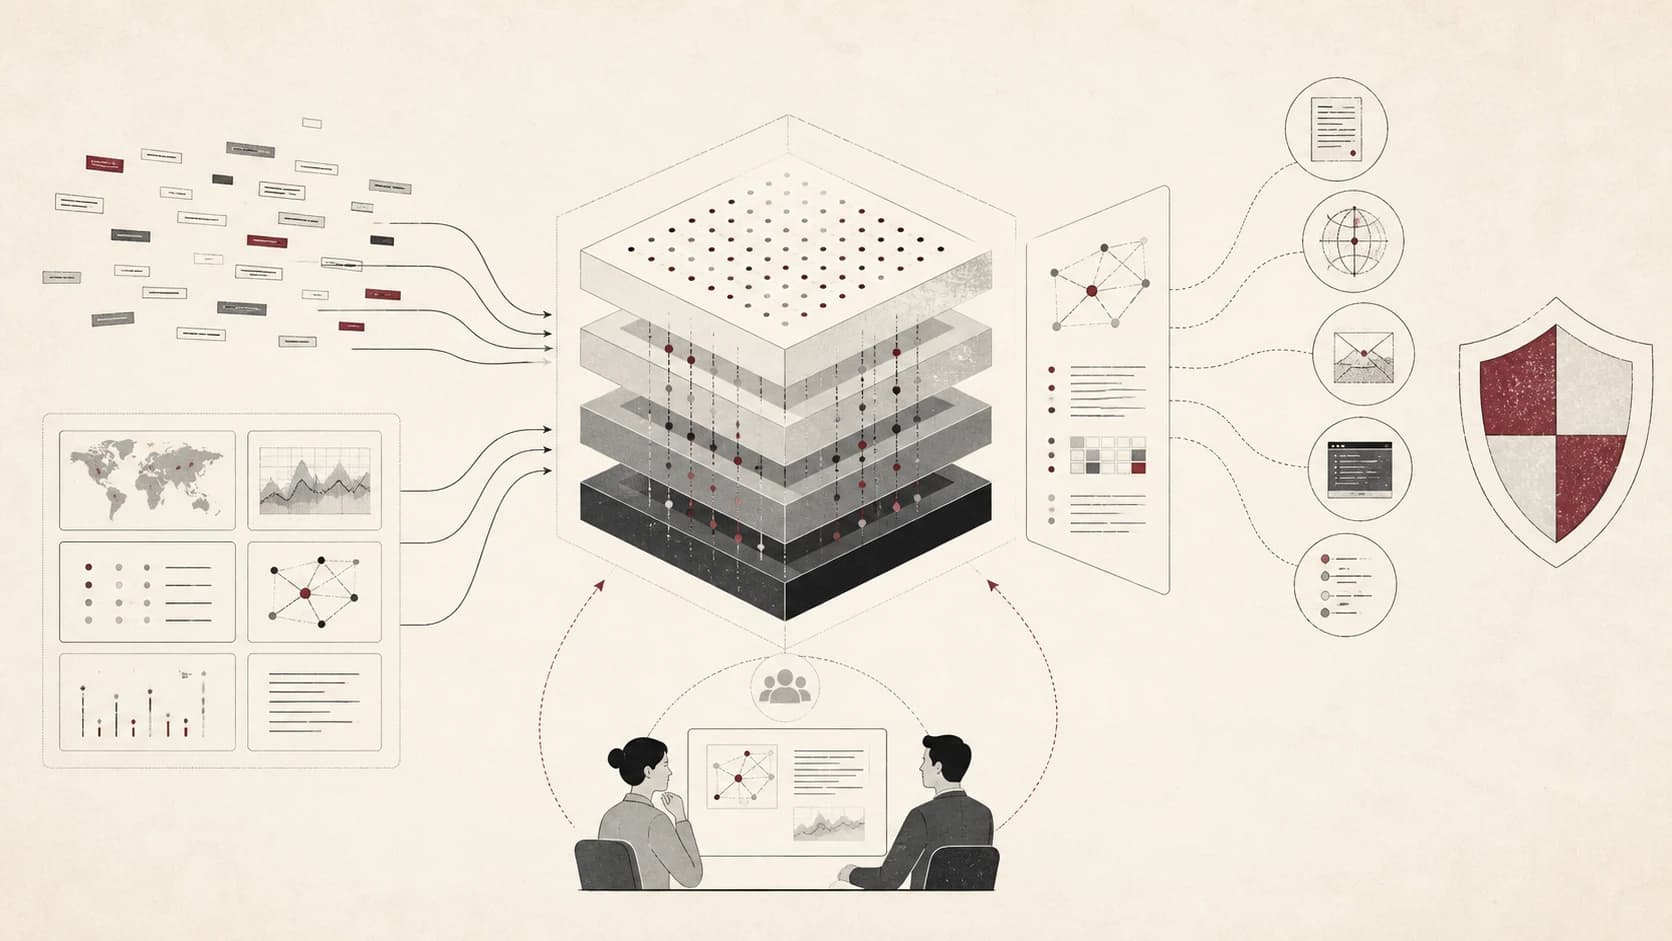
El RAG de seguridad necesita algo más que similitud semántica. La recuperación debe considerar:
- autoridad y versión del documento,
- vigencia temporal,
- alcance del activo o entorno,
- control de acceso,
- normalización de indicadores,
- si la evidencia es una observación, una regla o una hipótesis.
Un playbook obsoleto puede ser más peligroso que no tener playbook porque aparenta autoridad.
3. Separar calidad de recuperación y de generación
Si la respuesta es errónea, hay que preguntar si el recuperador no encontró la evidencia, escogió evidencia contradictoria o devolvió un contexto correcto que el generador utilizó mal. Guarda los identificadores y las puntuaciones recuperadas para localizar el fallo.
Para una respuesta con afirmaciones , una revisión de grounding puede estimar:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.Es un diagnóstico útil, no un sustituto de la revisión experta.
4. RAG no es un límite de seguridad por sí mismo
Los documentos recuperados pueden contener instrucciones maliciosas, datos sensibles o políticas contradictorias. La aplicación debe separar instrucciones y evidencia, filtrar el acceso antes de recuperar y evitar que el modelo trate el texto documental como un comando de sistema nuevo.
La salida debería incluir citas, incertidumbre y una negativa cuando el contexto sea insuficiente. Una respuesta que expresa certeza sin procedencia es una respuesta fallida.
5. Un despliegue disciplinado
Construye primero un corpus pequeño y versionado. Usa un golden set de consultas realistas, incluye documentos obsoletos y contradictorios, y evalúa recuperación y generación por separado. Añade correcciones humanas al conjunto de evaluación solo después de adjudicarlas.
RAG mejora el acceso al conocimiento actual. No elimina la necesidad de gobernar las fuentes, controlar el acceso y medir con cuidado.
Ejemplo: una vulnerabilidad y dos versiones de un playbook
Supón una consulta sobre qué procedimiento aplicar a un activo. El corpus contiene una guía antigua, una revisión vigente y una nota de incidente con instrucciones ajenas al procedimiento. La recuperación debe filtrar por permisos y ámbito, identificar la versión aplicable y conservar la guía anterior solo cuando ayude a explicar un cambio. La similitud de embeddings no resuelve ese conflicto.
Una estrategia híbrida puede combinar coincidencia léxica para identificadores exactos con búsqueda semántica para descripciones. Después, un reranker ordena los candidatos permitidos. Evalúa esa combinación frente a cada recuperador aislado: añadir capas no garantiza recuperar mejor y aumenta latencia y puntos de fallo.
Caso mínimo reproducible
Este corpus es ficticio y sirve para probar la selección de evidencia, no para actuar sobre un sistema real. Introduce los tres documentos con sus metadatos y conserva el identificador al fragmentarlos:
[
  {"id":"PB-1","asset":"demo-web","current":false,"allowed":true,"text":"La guía aplicable es la versión 1. Sustituida por PB-2."},
  {"id":"PB-2","asset":"demo-web","current":true,"allowed":true,"text":"La guía aplicable es la versión 2. Su revisión requiere aprobación del responsable."},
  {"id":"INC-1","asset":"demo-web","current":true,"allowed":false,"text":"Nota de incidente restringida."}
]
Consulta: «¿Qué versión de la guía debo consultar para demo-web y quién debe aprobar su revisión?». Filtra por activo, vigencia y permiso antes de construir el contexto. En este caso controlado solo PB-2 cumple las tres condiciones.
Respuesta esperada: «La versión 2; su revisión requiere aprobación del responsable [PB-2]». Registra los identificadores recuperados, el contexto entregado y la respuesta. El caso falla si cita PB-1 como vigente, expone INC-1, omite la cita o inventa un nombre para el responsable.
Repite retirando PB-2: la respuesta debe reconocer que no dispone de una guía vigente autorizada. Este control prueba restricciones y respaldo de la respuesta; no mide por sí solo la calidad de un recuperador semántico.
Diagnosticar dónde se pierde la respuesta
Propongo tres ejecuciones por caso: recuperación real, contexto correcto seleccionado manualmente y ausencia de contexto. Si el generador falla incluso con la evidencia correcta, el problema no se arregla aumentando top-k. Si solo acierta con el contexto manual, revisa indexación, filtros y ranking.
RAGChecker ofrece un enfoque de diagnóstico separado de recuperación y generación. El trabajo fundacional de Lewis y colaboradores explica la combinación de recuperación y generación; aplicarla a un SOC añade requisitos de vigencia y autorización específicos del entorno.
Revocación y cachés
Cuando se revoca un permiso o se retira un documento, revisa también fragmentos, respuestas cacheadas y resúmenes derivados. Una cita correcta no autoriza revelar el contenido. Diseña una prueba donde el usuario pierde acceso entre dos consultas y verifica que ningún resultado anterior reaparece indebidamente.
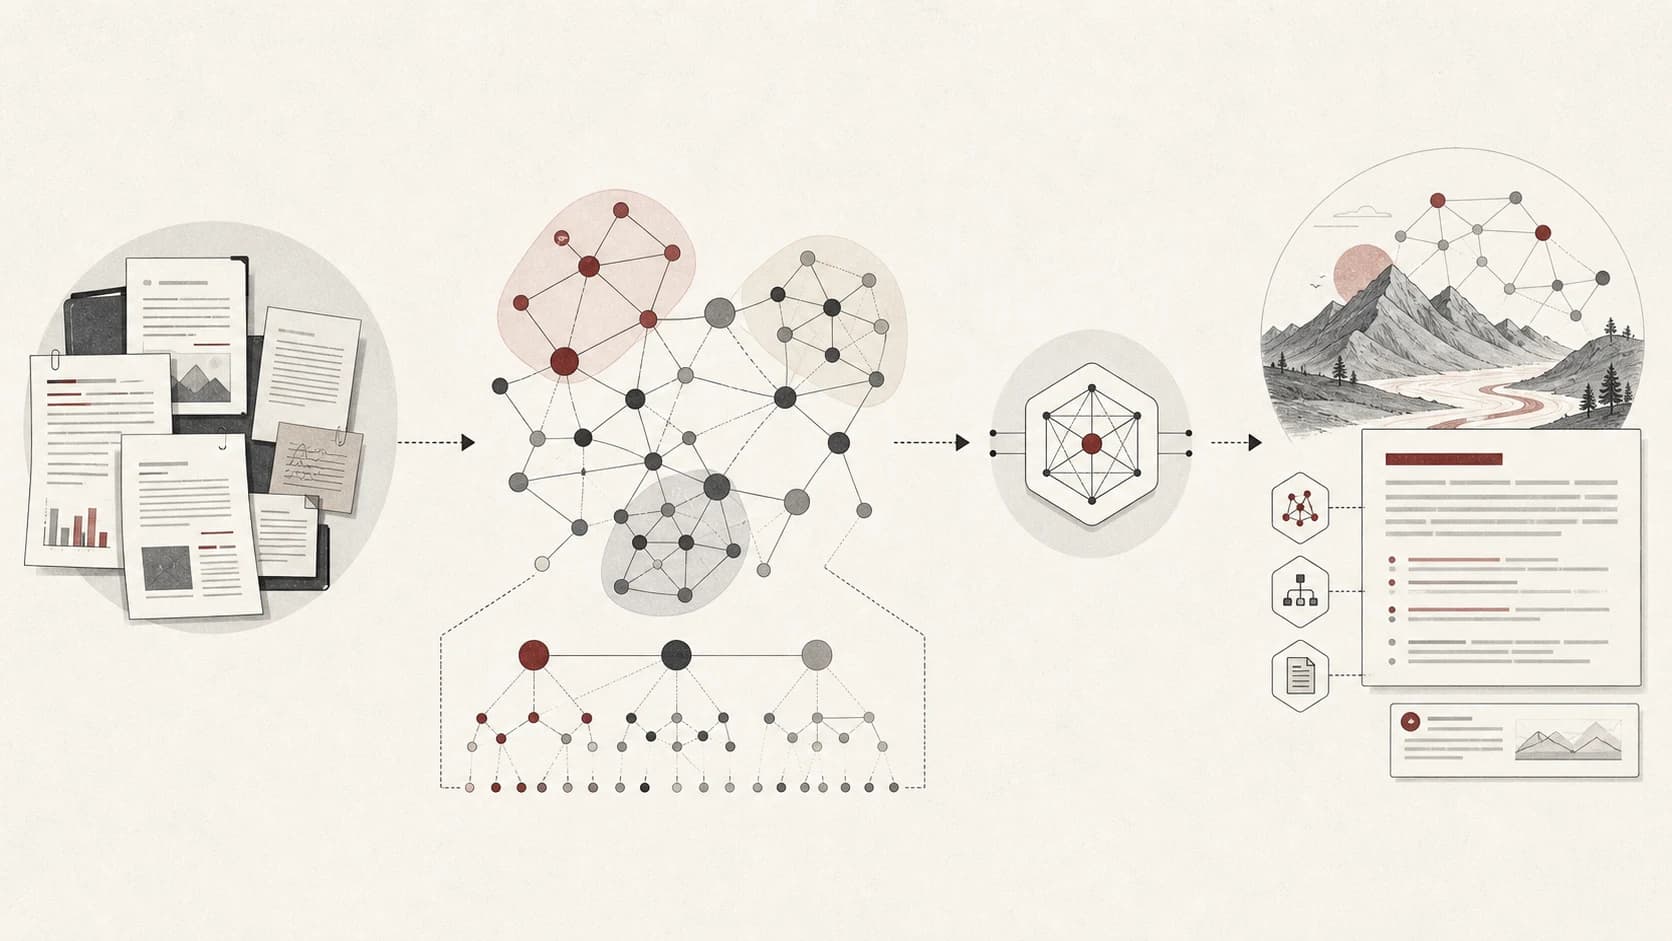
Para relaciones entre informes, consulta GraphRAG para inteligencia de amenazas. Para proteger el paso del documento a la herramienta, continúa con prompt injection en RAG y agentes.