En este artículo
Los grandes modelos de lenguaje están resultando útiles en ciberseguridad, pero es fácil exagerar su valor. Pueden resumir evidencias, traducir el lenguaje de un incidente a un vocabulario común, redactar consultas para un analista y descubrir conexiones entre informes extensos. No saben automáticamente si una afirmación de seguridad es cierta, actual o segura para actuar sobre ella.
El punto de partida más sólido es asignar al modelo un papel acotado dentro de un flujo donde la evidencia y la autoridad sigan siendo visibles.
1. Dónde puede ayudar un LLM
Un LLM puede apoyar varias partes de una operación de seguridad:
- traducir alertas a un resumen comprensible para el analista,
- extraer entidades, indicadores y relaciones de informes,
- proponer consultas para repositorios de inteligencia de amenazas,
- comparar una alerta con playbooks aprobados,
- solicitar el contexto que falta antes de proponer una respuesta,
- redactar un informe posterior al incidente con enlaces a la evidencia.
Son funciones de asistencia. Funcionan mejor cuando la salida es un artefacto intermedio estructurado y no una decisión final opaca.
2. Por qué la ciberseguridad es un dominio difícil
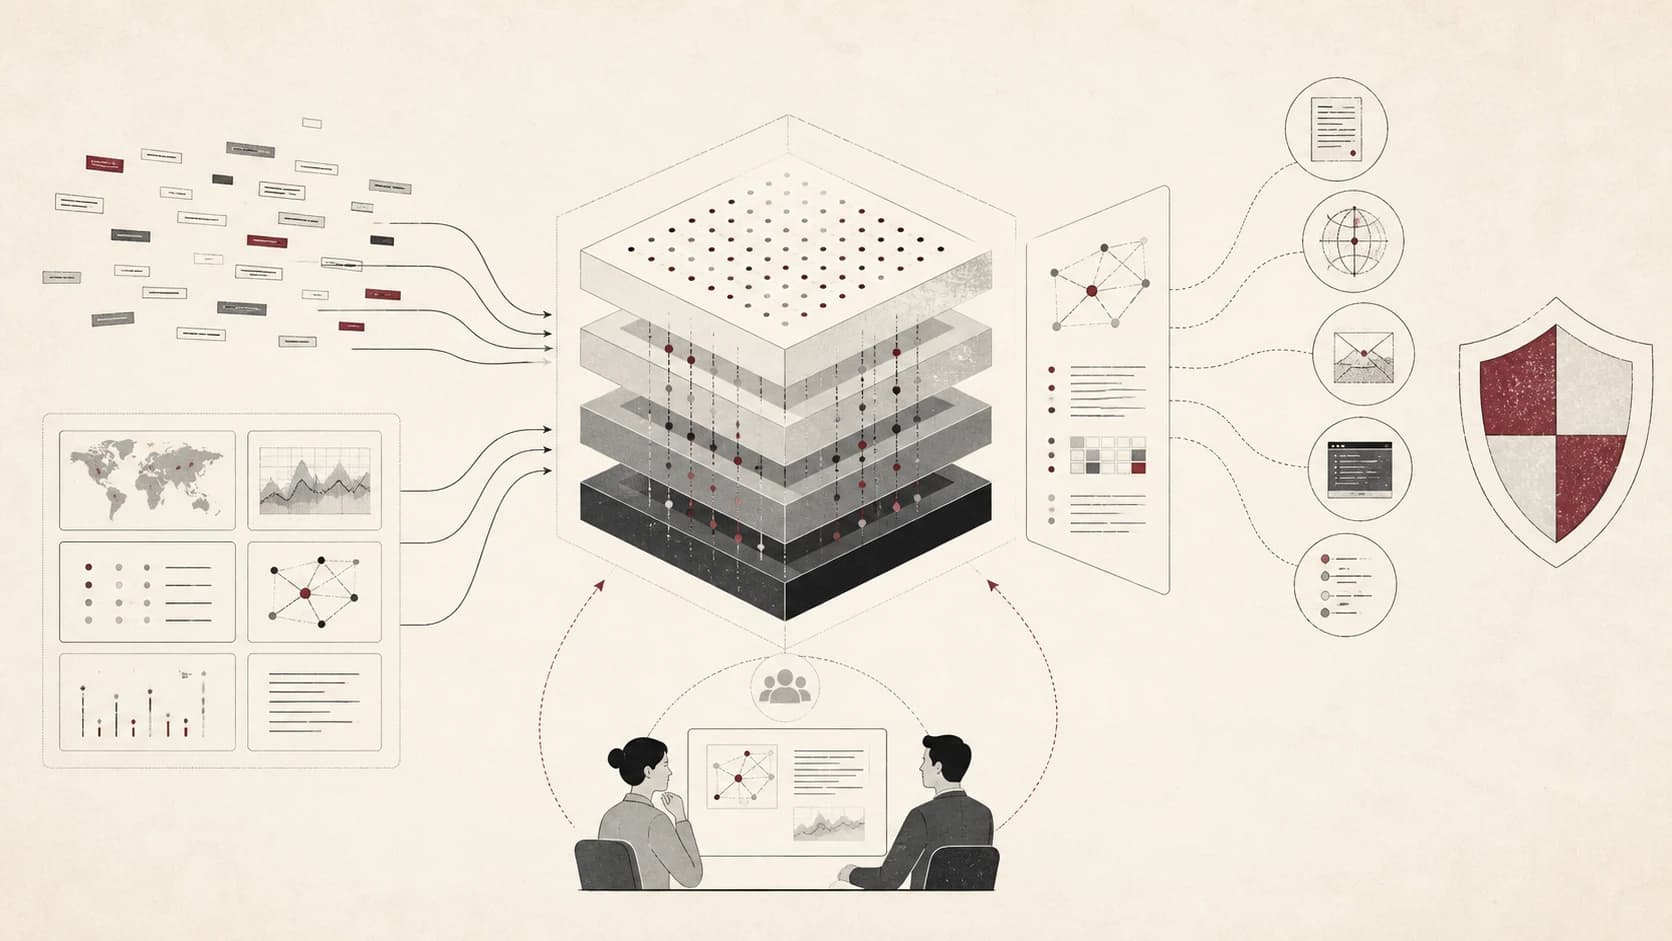
Los datos de seguridad son heterogéneos, cambian con el tiempo y pueden estar manipulados. Un hostname puede ser benigno en un entorno y sospechoso en otro. Un indicador puede estar obsoleto. Un informe puede describir una posibilidad en vez de un hecho observado. Además, la prompt injection puede llegar dentro de los documentos que el modelo debe resumir.
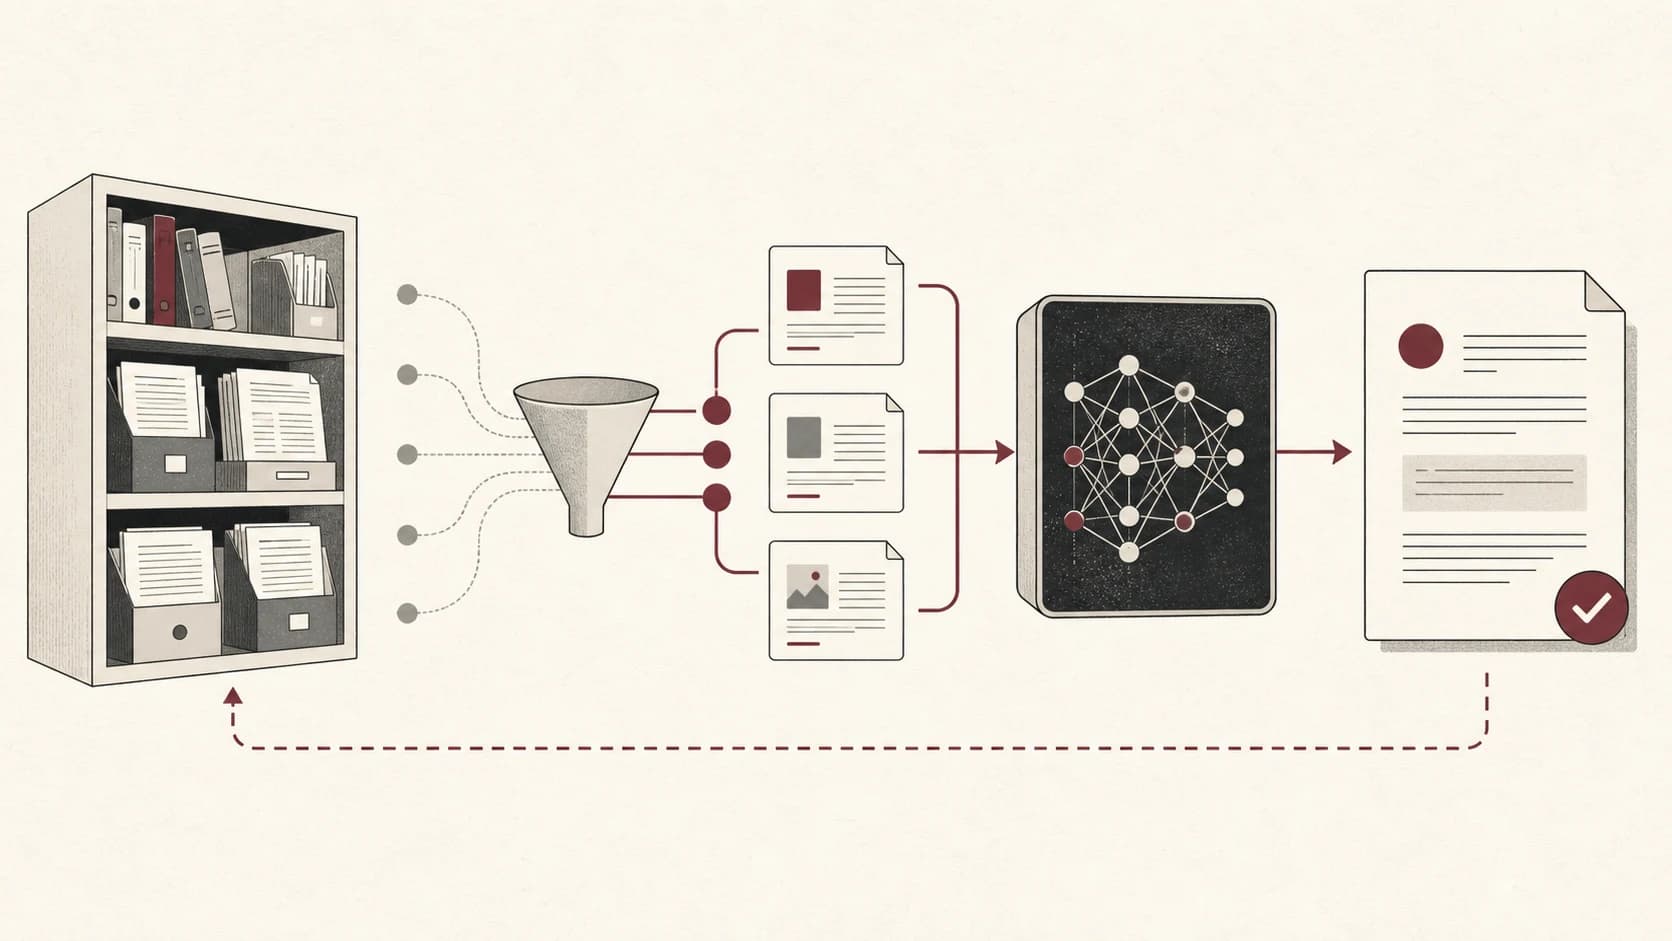
Por eso, el contexto enviado al modelo debe conservar la procedencia:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.donde es la observación, su fuente, su ventana temporal, su contexto local y una señal de calidad o confianza. Una respuesta en prosa sin esta tupla es difícil de auditar.
3. Un contrato de interacción más seguro
El prompt operativo debe definir qué puede hacer el modelo y qué no debe hacer. Debe exigir:
- separar hechos observados de hipótesis;
- citar o identificar la fuente de cada afirmación relevante;
- declarar la incertidumbre cuando la evidencia sea incompleta;
- no ejecutar comandos ni cambiar políticas sin una aprobación externa;
- conservar un registro estructurado de la petición, el contexto y la respuesta.
Este contrato es más importante que un prompt ingenioso. Convierte al modelo en un componente controlado y no en un operador imposible de revisar.
4. Evaluar algo más que un texto fluido
La fluidez no es una métrica de seguridad. La evaluación debe comprobar si el modelo conserva los indicadores, evita inventar etapas del ataque, distingue recomendación de acción y sigue siendo útil cuando la evidencia es contradictoria.
Para una respuesta y un conjunto de evidencias , un registro sencillo puede combinar utilidad y disciplina de evidencia:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.donde mide utilidad, grounding, afirmaciones no respaldadas y autoridad insegura. Los términos deben medirse por separado, no ocultarse en una única puntuación.
5. Un primer despliegue práctico
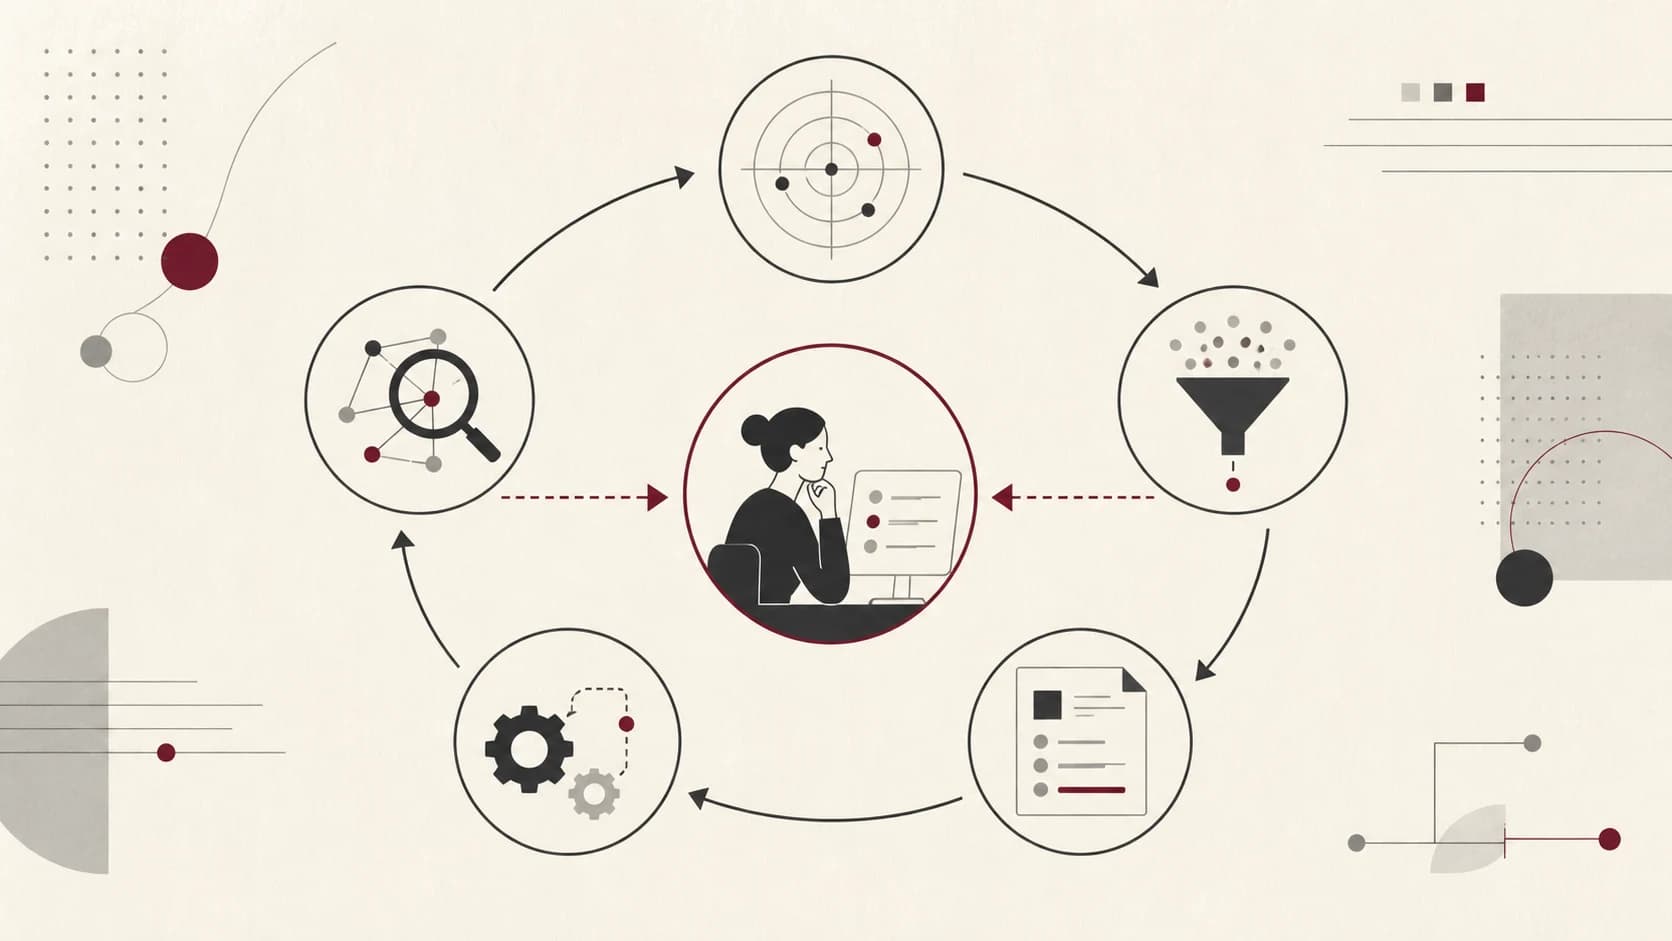
Empieza con un asistente de solo lectura para una cola concreta. Guarda la evidencia de entrada, los documentos recuperados, la versión del modelo, la respuesta y la corrección del analista. Revisa los fallos cada semana y amplía el papel solo cuando entiendas el patrón de correcciones.
El objetivo no es que el LLM parezca un experto. Es acelerar el razonamiento del analista manteniendo auditable la evidencia, la incertidumbre y la autoridad de decisión.
Elegir una tarea del SOC con un criterio de aceptación
Para empezar, propongo una tarea verificable: convertir una alerta y sus eventos asociados en un resumen con activo, cronología, evidencias e incógnitas. La respuesta es aceptable si conserva identificadores, distingue intento de acceso de acceso confirmado y enlaza cada conclusión con un evento. Un texto convincente que inventa una escalada de privilegios debe suspender.
Compara el asistente con una plantilla sin LLM. Usa los mismos incidentes y mide tiempo de revisión, omisiones y correcciones. Alterna el orden de presentación para reducir el efecto de familiaridad del analista. Esta comparación permite saber si el modelo aporta algo frente a una automatización más sencilla.
Qué cambia al incorporar herramientas
Un resumidor y un agente con acceso a consultas o acciones tienen superficies de fallo distintas. El segundo puede equivocarse en parámetros, destinatarios o alcance, incluso cuando su explicación parece correcta. Registra por separado texto generado, llamadas propuestas, llamadas autorizadas y efectos observados. Los permisos deben aplicarse en el servicio que ejecuta la herramienta.
La revisión sistemática de Xu y colaboradores sitúa los agentes entre las líneas de evolución de LLMs para seguridad. Para estudiarlos de forma operativa, AgentDojo proporciona un entorno de evaluación de tareas y prompt injection. Ninguno sustituye una prueba con tus datos, herramientas y reglas de autorización.
Cuándo ampliar el alcance
Amplía la tarea cuando conozcas los errores que siguen apareciendo, puedas detectar una regresión y exista una vía de retorno al flujo anterior. Define estos criterios antes del piloto. La aprobación por un analista no convierte automáticamente la salida en una etiqueta correcta para reentrenar.
Continúa con RAG para ciberseguridad, golden sets de evaluación y pruebas de prompt injection.