En este artículo
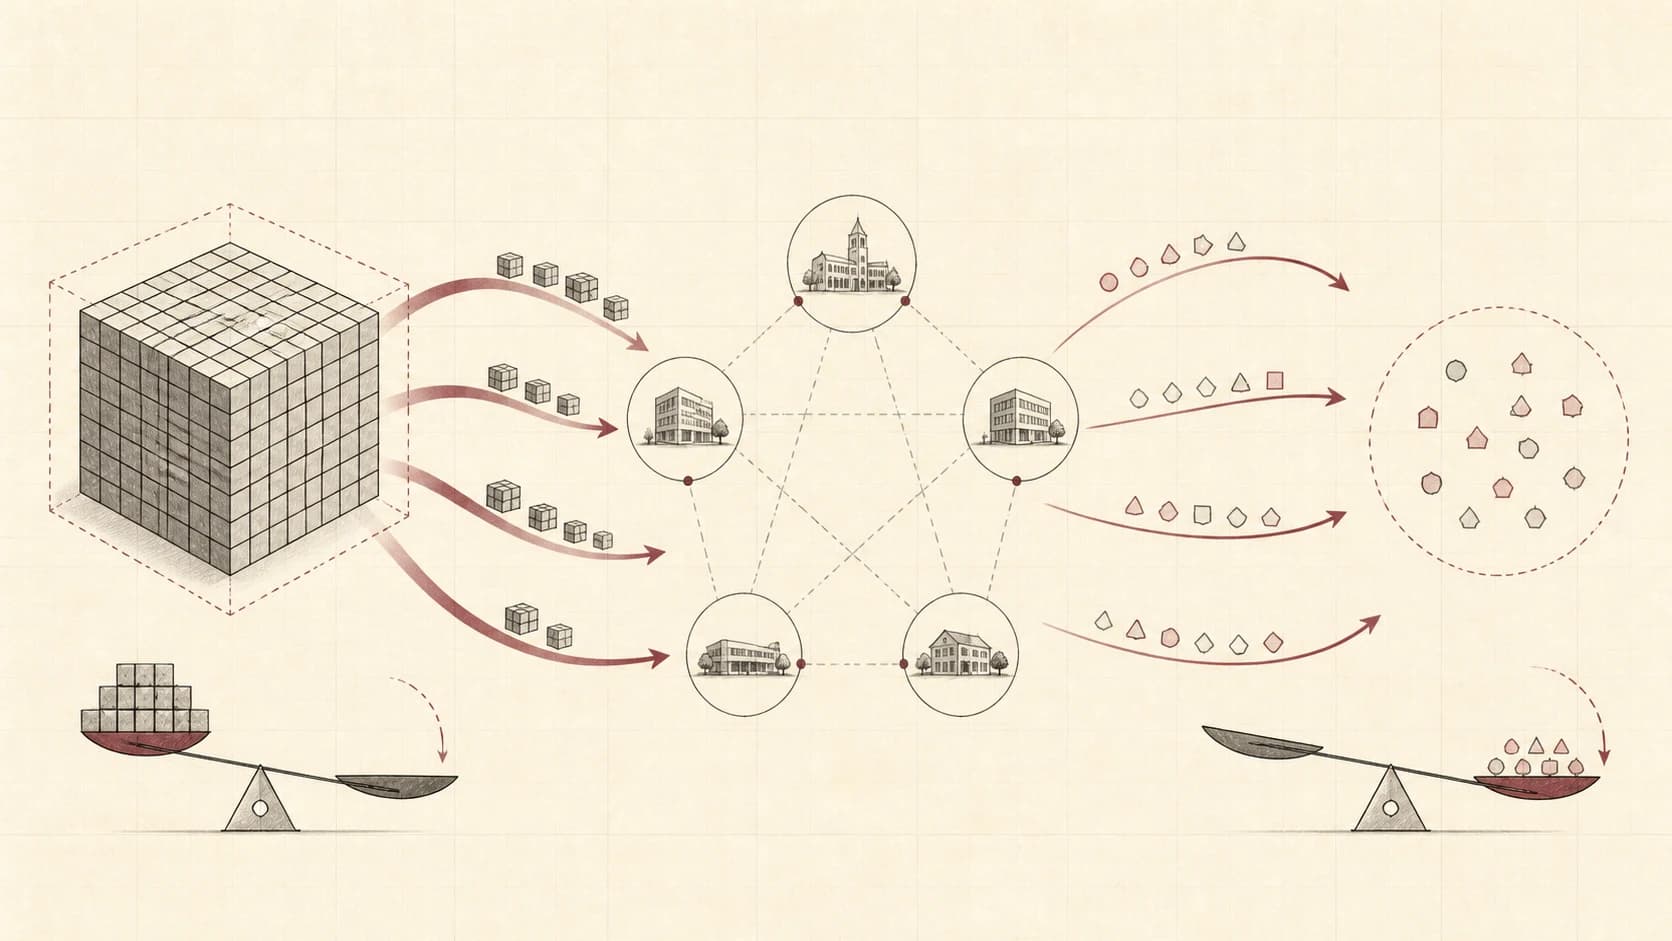
La comunicación suele ser el coste oculto del aprendizaje federado descentralizado. Un dispositivo puede tener suficiente capacidad para entrenar localmente, pero no disponer de ancho de banda o batería para intercambiar un modelo grande en cada ronda. Los experimentos con prototipos de la tesis hacen tangible este compromiso: a veces la optimización más importante consiste en elegir un objeto más pequeño que comunicar.
Un modelo de coste sencillo
Sea el número de parámetros del modelo y los bytes utilizados para codificar cada parámetro. Un mensaje con el modelo completo tiene un payload aproximado:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.Si un cliente envía clases, modalidades y prototipos de dimensión , el payload correspondiente puede aproximarse como:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.donde es la precisión del prototipo y cubre máscaras, etiquetas, versiones y metadatos de integridad. La aproximación es deliberadamente sencilla. Sirve para mostrar qué decisiones impulsan la comunicación: tamaño de representación, número de clases, modalidades y metadatos.
Compresión, sparsification y cuantización pueden reducir cualquiera de los dos payloads, pero no cambian la pregunta arquitectónica. ¿Están intercambiando los vecinos más información de la que necesitan para el objetivo de colaboración?
Qué muestra la tabla de recursos de Modalis
En la configuración de recursos AVMNIST comunicada, el mensaje medio de cada cliente en Modalis es de aproximadamente 0,11 MB. FedAvg y varias líneas base basadas en modelos completos o intensivas en comunicación se sitúan alrededor de 4,75 a 4,85 MB por mensaje, con PmcmFL cerca de 4,80 MB. En esa comparación, el mensaje de prototipos es más de 40 veces menor que el de las líneas base más grandes.
El F1 correspondiente de Modalis se informa como 83,4%. La tabla también ofrece cifras aproximadas de 44% de CPU, 70% de GPU y 31% de RAM para el método estudiado. Son valores de una configuración de benchmark y deben servir para discutir compromisos, no como requisitos universales de cualquier dispositivo.
Los bytes no son la única métrica
Un mensaje pequeño puede seguir siendo un mal diseño si transporta información inestable o engañosa. Por eso la eficiencia debería evaluarse con:
- payload por cliente y ronda,
- número de rondas hasta alcanzar una calidad objetivo,
- retransmisiones y mensajes perdidos,
- coste energético o de recursos de codificar y decodificar,
- calidad final por modalidad y tipo de cliente,
- sensibilidad a prototipos retrasados o ausentes.
El coste total se expresa mejor como:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.donde es el número de rondas de comunicación. Un método con payload diminuto, pero el doble de rondas, puede no ser más barato de extremo a extremo.
Por qué los prototipos pueden encajar
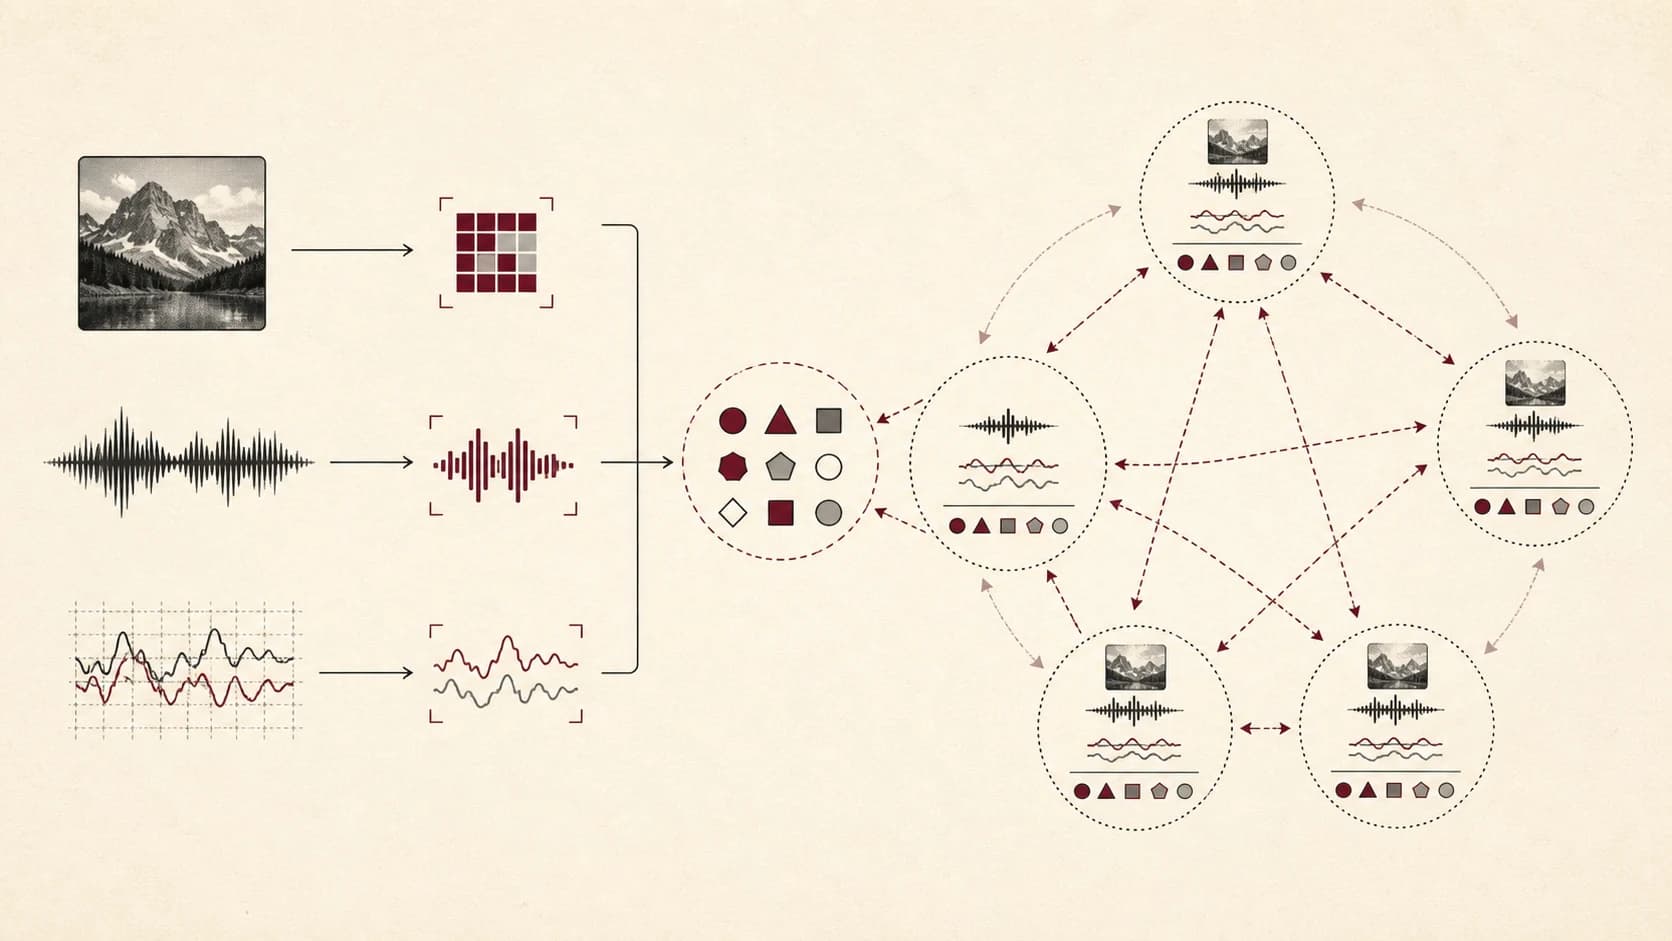
En un entorno multimodal, los vecinos no siempre necesitan una copia de cada capa. Pueden necesitar una descripción compacta de cómo aparece una clase en un espacio de representación, incluyendo conocimiento aprendido desde una modalidad que falta localmente. Los prototipos encajan mejor con ese intercambio semántico que un estado bruto del optimizador.
Hay varios matices:
- Una clase con pocos ejemplos puede producir un prototipo ruidoso.
- Los prototipos pueden quedar desactualizados cuando cambia el modelo local.
- Un prototipo todavía puede filtrar información de su distribución de origen.
- Las máscaras y versiones añaden sobrecarga y deben contabilizarse.
Por tanto, el ahorro debe acompañarse de umbrales de soporte, versionado, comprobaciones de integridad y evaluación de filtraciones.
Un patrón práctico para informar
Al comparar protocolos DFL conviene comunicar tanto el payload como la curva de aprendizaje. Una tabla útil incluye tamaño de mensaje, número de rondas, bytes acumulados, F1 o pérdida, recursos y configuración de clientes y grafo. Así puede distinguirse una representación verdaderamente eficiente de un método que simplemente comunica menos mientras aprende menos.
Los resultados de la tesis apuntan a una dirección productiva: intercambiar representaciones compactas y relevantes para la tarea cuando los modelos completos son innecesariamente caros, y estudiar después cómo cambian los ahorros con la topología, las modalidades ausentes y la robustez. La eficiencia no es un detalle cosmético. Puede decidir si el aprendizaje descentralizado cabe en la red.
De bytes por mensaje a bytes por resultado útil
Una comparación necesita declarar si MB representa bytes decimales, si cuenta envío o recepción y si incluye todas las aristas. En una malla, un mismo payload puede transmitirse a varios vecinos. El coste total del experimento debe sumar esos envíos, control, reintentos y cualquier sincronización inicial del modelo.
Para un presupuesto fijo, compara calidad alcanzada. Para una calidad objetivo, compara bytes y tiempo necesarios. Son dos preguntas distintas y ambas son útiles. Si una técnica no llega al objetivo antes del límite, informa de esa condición en vez de comparar únicamente las ejecuciones exitosas.
Cuantizar no es solo cambiar la precisión
Propongo evaluar prototipos en distintas precisiones manteniendo la dimensión y el reparto de datos. Comprueba error de reconstrucción, estabilidad de alineación y recall en clases con poco soporte. Una reducción de bytes que perjudica precisamente a los clientes con modalidades ausentes puede contradecir el objetivo del método.
La publicación de Modalis en Information Fusion es la referencia para sus resultados. El trabajo sobre gossip comprimido ofrece otra perspectiva sobre comunicación y aprendizaje. Sus garantías no deben trasladarse automáticamente al intercambio de prototipos.
Una extensión reciente para estudiar
Li y colaboradores, AISTATS 2026 estudian comunicación comprimida y robustez bizantina con mecanismos de momento y reducción de varianza. Ese resultado abre una pregunta de diseño: cómo cambia el compromiso al comprimir representaciones que además se filtran por fiabilidad. Probarlo en Modalis requeriría un experimento nuevo.
Consulta cómo funciona Modalis y la compatibilidad entre privacidad y robustez antes de combinar mecanismos.