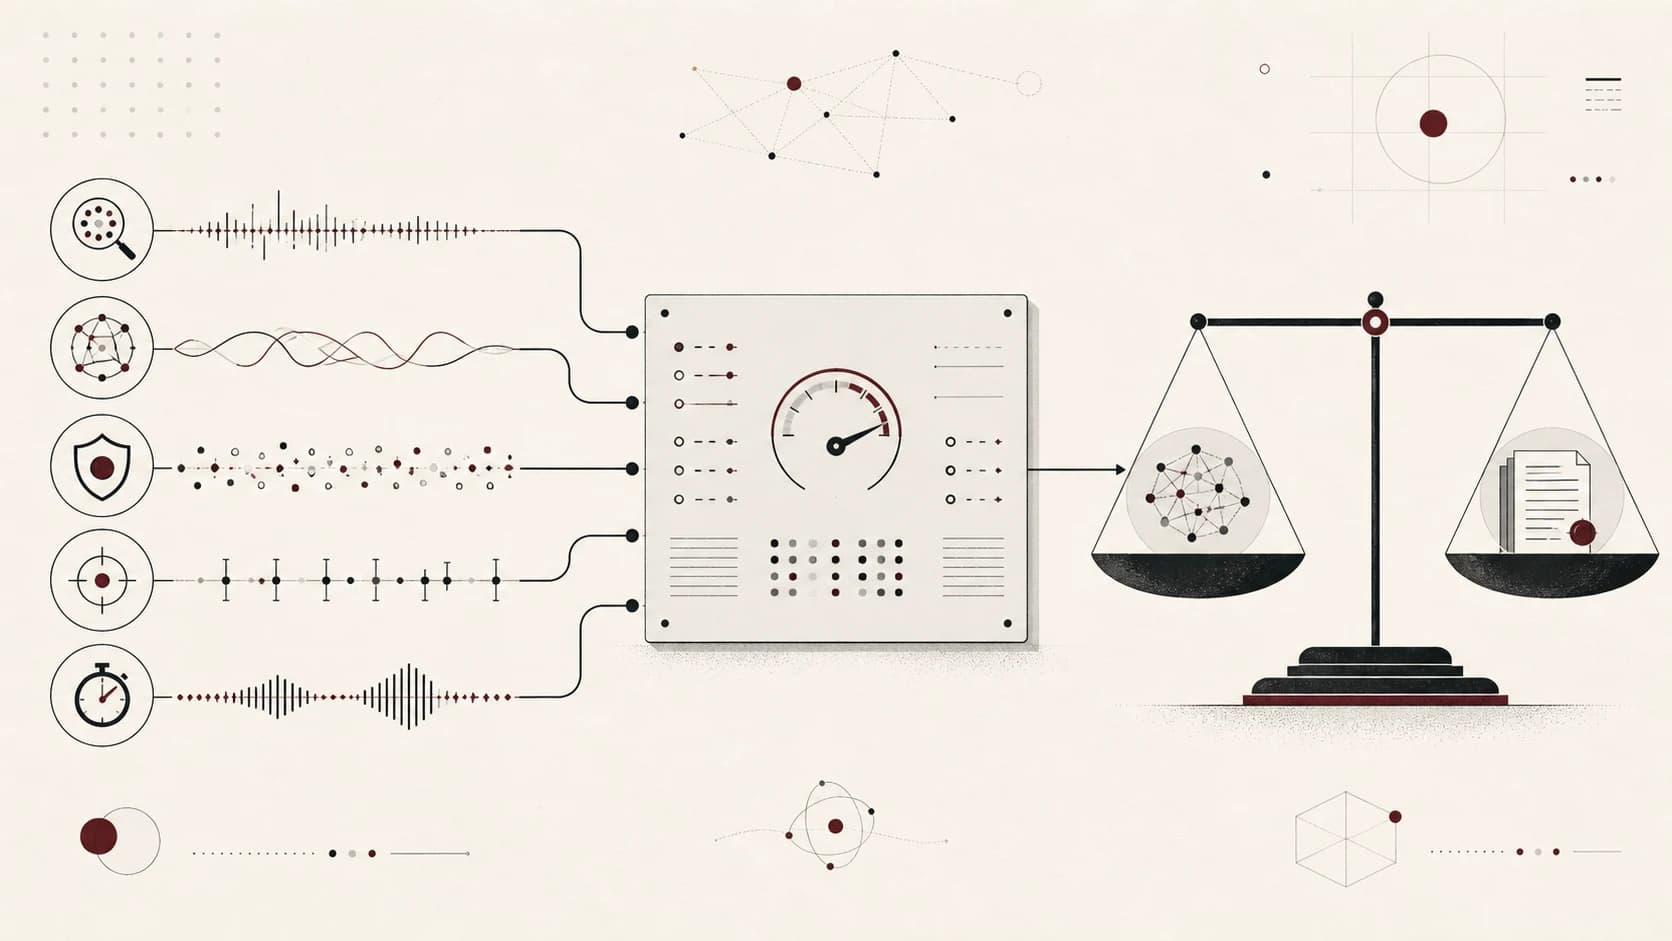
La evaluación de LLMs se vuelve engañosa cuando se pide a un único número resumir todo el sistema. Un asistente de seguridad puede ser fluido pero no estar grounded, correcto pero demasiado lento, seguro pero poco útil, o preciso en casos comunes y fallar ante incidentes raros de alto impacto.
La respuesta es una pila de medición cuyas dimensiones sigan visibles.
1. Calidad de la tarea
Empieza por la tarea. Según el flujo, mide F1 de extracción, calidad de clasificación, corrección de respuesta, calidad del ranking o utilidad valorada por personas. La métrica debe corresponderse con la decisión que apoya el sistema.
2. Evidencia y grounding
En RAG, mide recall y precisión de recuperación, corrección de citas, soporte de afirmaciones y completitud de respuesta. Una respuesta puede ser relevante para la pregunta y aun así incluir una afirmación sin respaldo.
Para afirmaciones y evidencia , informa al menos de:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.Agrega el resultado con cuidado y conserva los casos inciertos en vez de forzarlos a una puntuación binaria.
3. Seguridad y robustez
La evaluación de seguridad debe incluir calidad de la negativa, resistencia a prompt injection, exposición de datos sensibles, tasa de acciones inseguras y comportamiento con contexto contradictorio o manipulado. Los casos de red team solo sirven cuando el escenario y el criterio de éxito están definidos.
4. Calibración y abstención
Si el modelo emite confianza, comprueba si se relaciona con la corrección. Un asistente bien calibrado debería saber cuándo pedir más evidencia o escalar. Abstenerse no es fallar cuando el coste de una acción sin respaldo es alto.
5. Operación y uso humano
Mide latencia, coste de tokens y recuperación, memoria, disponibilidad, tiempo de corrección del analista y porcentaje de recomendaciones aceptadas sin cambios. Estas métricas muestran si el modelo funciona en el ciclo real y no solo en un benchmark.
6. Informar del vector y no de una puntuación de vanidad
Un panel puede mostrar un vector:
Si no ves la fórmula completa, enfócala y usa las flechas izquierda y derecha, o desliza horizontalmente.para calidad de tarea, grounding, seguridad, calibración, latencia y utilidad humana. Sus componentes deben acompañarse del dataset, la política y la versión del modelo que los produjo.
La evaluación más creíble hace explícitos los compromisos. Indica qué mejoró, qué empeoró y qué fallos siguen siendo posibles.
Definir los denominadores antes de medir
Dos tasas con el mismo nombre pueden medir cosas distintas. Para recuperación, define si una unidad relevante es un documento, fragmento o evidencia independiente. Para citas, separa cobertura de afirmaciones y corrección de las citas emitidas. Una respuesta con una única afirmación citada puede tener citas correctas y omitir casi toda la información solicitada.
| Medida | Denominador que debe declararse |
|---|---|
| Recall de recuperación | Evidencias relevantes del conjunto anotado |
| Cobertura de citas | Afirmaciones verificables de la respuesta |
| Acción insegura | Casos evaluados o intentos de acción, según protocolo |
| Éxito útil | Tareas legítimas evaluables |
| Abstención | Consultas presentadas, separando las respondibles |
Incertidumbre y comparación de versiones
Compara versiones sobre los mismos casos para estudiar diferencias pareadas. Si varias consultas proceden del mismo incidente, calcula la incertidumbre respetando ese agrupamiento. No las trates como observaciones independientes. Conserva fallos individuales y acompaña medias con distribución de resultados por idioma, tarea y riesgo.
En salidas estocásticas, repite una parte del conjunto para medir variación entre ejecuciones. Un resultado de cero fallos observados en una muestra pequeña no demuestra probabilidad de fallo nula. Indica tamaño de muestra y límites de la inferencia.
Jueces automáticos y calibración
RAGChecker aporta diagnóstico fino, pero cualquier juez automático requiere contraste con etiquetas humanas del dominio. Revisa sesgos por longitud, orden y estilo. La confianza verbal del LLM tampoco equivale a una probabilidad calibrada: valida la relación entre confianza y corrección antes de usar umbrales.
El preprint Safety, or Just Capability? refuerza la necesidad de especificar qué conducta mide un benchmark. Para construir casos, consulta golden sets; para medir fallos en herramientas, el protocolo de seguridad de agentes.